
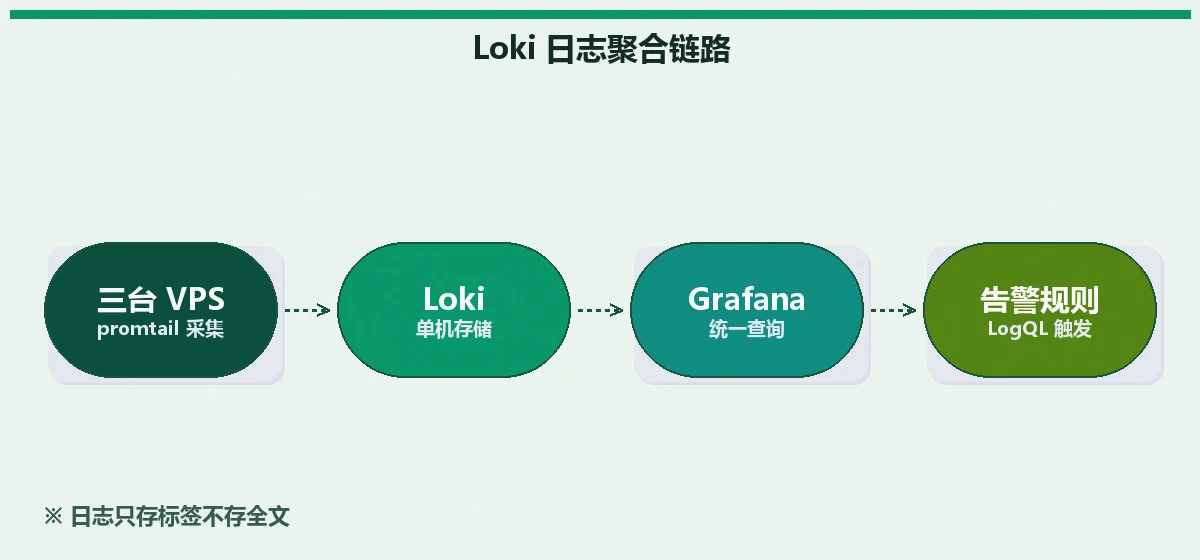
Loki 的思路是「只索引标签、不索引日志正文」,存储成本比 ELK 低一个数量级,一台 2 核 2G 的小 VPS 就能当三台机器的日志中心:每台机器跑一个 Promtail 推日志到中心 Loki,Grafana 里一个下拉框切换来源,LogQL 查错就那几条固定句式。 2026 年 10 月我把三台 Ubuntu 22.04 的 VPS(Docker 27)接进了这套系统,中心节点常驻内存不到 400MB,磁盘占用三周才 1.8G。在那之前我的排障流程是「ssh 到三台机器挨个 grep」,一次跨机排查要十分钟起步;现在是在 Grafana 的搜索框里敲一行 LogQL,秒出结果。
为什么不用 ELK?
结论:个人和中小团队查日志的核心动作是「按时间 + 按关键词过滤」,ELK 的全文索引在这个场景里是拿成本换用不上的能力,Loki 把索引范围缩小到标签,正好够用。
| 维度 | ELK | Loki |
|---|---|---|
| 索引对象 | 全文,倒排索引 | 只有标签(job、host 等少量维度) |
| 存储占用 | 同样日志量约为 Loki 的 8-10 倍 | 压缩后极小 |
| 内存需求 | 起步 4G 起,JVM 吃大户 | 2G 机器能跑 |
| 查询语言 | KQL/Lucene,功能强大 | LogQL,简单场景够用 |
| 慢查询 | 全文检索快 | 无标签过滤会慢(要加时间范围) |
| 部署复杂度 | ES + Logstash + Kibana 三件套 | 单二进制 |
我的取舍标准:日志量大到需要全文检索(比如按任意字段聚合分析、给业务方自助查数),上 ELK;目标是「出问题时快速定位哪个容器报了什么错」,Loki 完胜。 Grafana 是两者共用的展示层,如果你已经按监控入门那篇部署了 Prometheus + Grafana,Loki 只是「加一个数据源」的事,顺手程度翻倍。
部署怎么走?
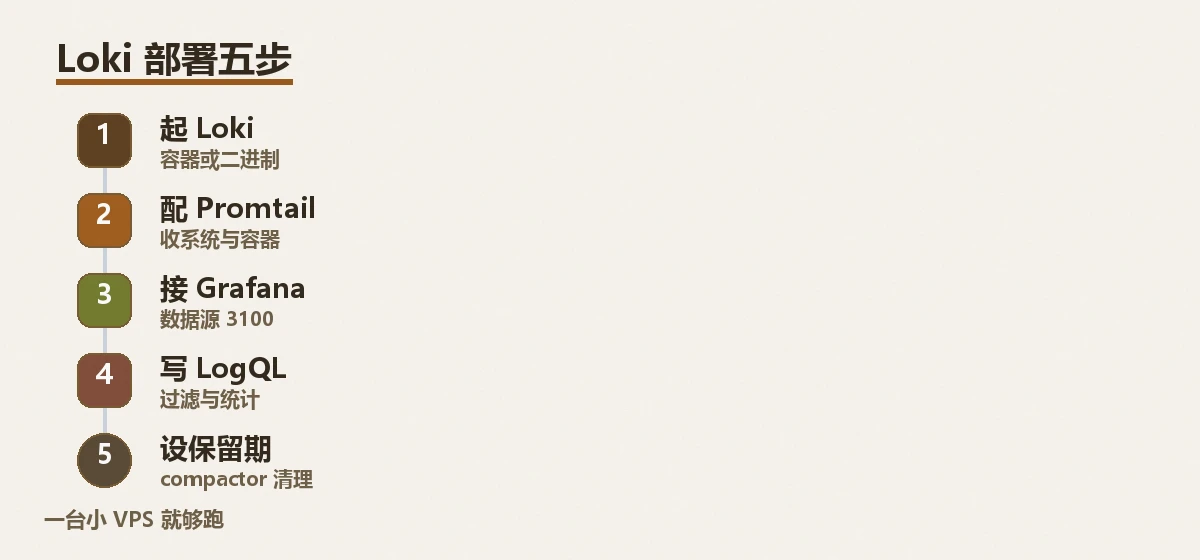
架构很简单:中心机跑 Loki(存储+查询接口)和 Grafana,三台机器各跑一个 Promtail 往中心推。四步部署。
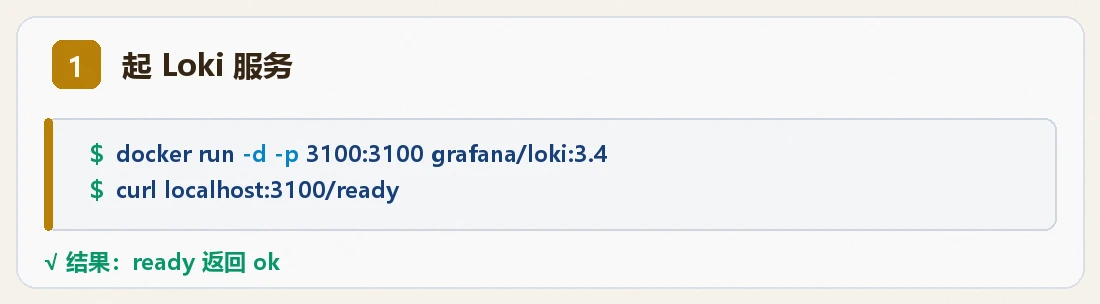
第一步:中心机起 Loki 3.x
services:
  loki:
    image: grafana/loki:3.2.0
    restart: unless-stopped
    command: -config.file=/etc/loki/loki-config.yml
    volumes:
      - ./loki-config.yml:/etc/loki/loki-config.yml:ro
      - ./data:/loki
    ports:
      - "127.0.0.1:3100:3100"

  grafana:
    image: grafana/grafana:11.2.0
    restart: unless-stopped
    environment:
      - GF_SECURITY_ADMIN_PASSWORD=换成强密码
    volumes:
      - ./grafana:/var/lib/grafana
    ports:
      - "127.0.0.1:3000:3000"
两个端口都绑 127.0.0.1:Loki 是纯内部接口,Grafana 要么走反代加认证,要么通过 SSH 隧道访问。3100 是 Loki 的 HTTP API 端口,Promtail 推日志、Grafana 查数据都走它。
第二步:loki-config.yml 与保留期
单机模式的关键配置:
auth_enabled: false
server:
  http_listen_port: 3100

common:
  path_prefix: /loki
  storage:
    filesystem:
      chunks_directory: /loki/chunks
  replication_factor: 1
  ring:
    kvstore:
      store: inmemory

schema_config:
  configs:
    - from: 2024-01-01
      store: tsdb
      object_store: filesystem
      schema: v13
      index:
        prefix: index_
        period: 24h

limits_config:
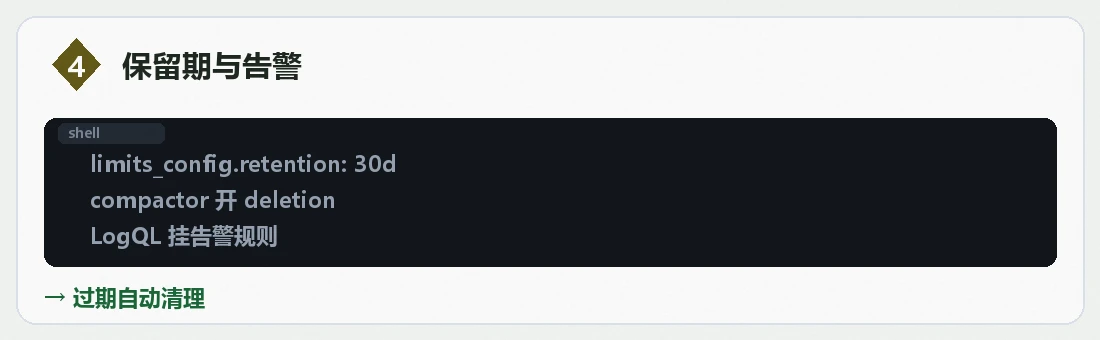
  retention_period: 30d

compactor:
  working_directory: /loki/compactor
  retention_enabled: true
  delete_request_store: filesystem
注意一个反直觉的点:只写 retention_period: 30d 不会删日志,必须同时开 compactor 的 retention_enabled: true,清理动作才真正发生。 我见过日志中心默默把盘写满的案例,和容器日志吃满 40G 系统盘是同一类事故,只是换了个组件。30 天对排障足够,三台机器实测一个月 2G 出头,40G 的小盘也扛得住。磁盘被写满前的排查套路在VPS 磁盘排查里。
第三步:每台机器跑 Promtail
server:
  http_listen_port: 9080
positions:
  filename: /tmp/positions.yaml
clients:
  - url: http://<中心机IP>:3100/loki/api/v1/push

scrape_configs:
  - job_name: system
    static_configs:
      - targets: [localhost]
        labels:
          job: varlogs
          host: vps-shanghai-01
          __path__: /var/log/*log

  - job_name: docker
    static_configs:
      - targets: [localhost]
        labels:
          job: docker
          host: vps-shanghai-01
          __path__: /var/lib/docker/containers/*/*.log
    pipeline_stages:
      - json:
          expressions:
            stream: stream
            log: log
      - labels:
          stream:
      - output:
          source: log
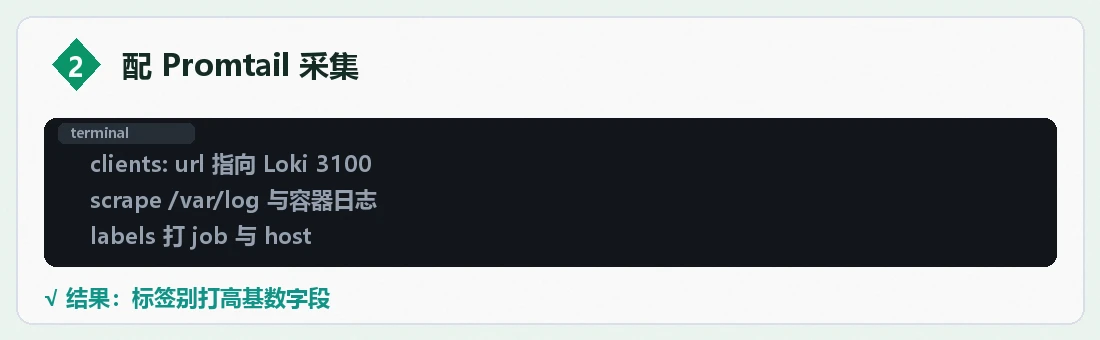
三处要点:host 标签手动写死每台机器的名字,这是多机场景最重要的标签,Grafana 里按它筛选;Docker 容器日志是 JSON 格式,pipeline_stages 把真实的日志行从 JSON 里剥出来,只把 stream(stdout/stderr)留成标签;positions.yaml 记录采集进度,Promtail 重启后从断点续传,不会重复推。注意中心机的 Loki 要让三台机器的 3100 可达——我是通过反代加了 basic auth 暴露的,也可以走 WireGuard 隧道。
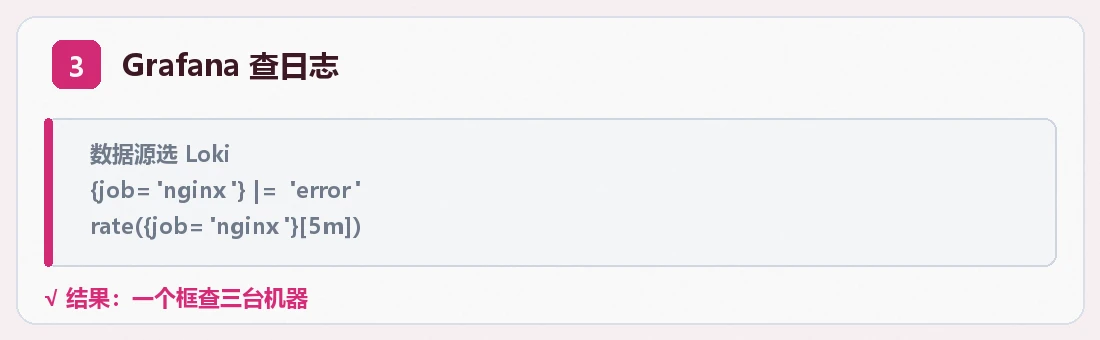
第四步:Grafana 加数据源与 LogQL 实战
Grafana 里 Connections → Data sources → 加 Loki,URL 填 http://loki:3100(同 compose 网络时用服务名),保存测试。然后在 Explore 里就能查了,日常五条句式:
{job="docker"} |= "error"
{job="docker", host="vps-shanghai-01"} |= "OOM"
{job="varlogs"} |~ "ERROR|CRIT"
{job="docker"} |= "error" != "healthcheck"
rate({job="docker"} |= "error" [5m])
|= 是包含、!= 是排除、|~ 是正则。第五条 rate 把错误条数变成每秒速率,画成曲线后「从下午三点开始报错变多」这类趋势一眼可见——这比逐条翻日志快太多。第四条排 != 的例子是我的常用组合:健康检查每 30 秒刷一行错误属于噪音,用排除语句过滤掉,真正的异常才浮出来。
两个大坑,都真实发生过
坑一:时间不同步导致日志「消失」。我一开始以为是 Promtail 推送失败,反复查网络和权限,后来发现是那台机器的时钟快了四分钟,Loki 拒收「来自未来」的日志——服务端有 reject_old_samples 和时间窗口校验,时间戳异常的行直接丢弃,连报错都很隐蔽。 解法是给所有机器上 systemd-timesyncd 并确认 timedatectl status 里 NTP 是 enabled。VPS 供应商的时钟漂移不稀奇,接日志系统前先统一校时,能省两小时排查。
坑二:标签基数爆炸。 我试过把容器 ID 加进标签,两天后 Loki 内存翻倍、查询变卡——每个标签值的组合都会创建一条独立的流(stream),容器 ID 这种高频变化的值让流数量暴涨,官方叫「cardinality explosion」。原则:标签只放低基数的值,比如 host(三台机器三个值)、job、stream;容器名这种想查的话,放进日志正文用 LogQL 的行过滤去查,而不是当标签。
三周用下来的真实感受
这套系统没有让我失望的地方是查询速度和存储成本,失望的地方也有:LogQL 没法做复杂统计分析,想算「哪天报错最多」这类聚合要绕着写;标签设计一旦定型,改起来要动所有采集端。但作为「三台机器、一个搜索框、三十天保留」的目标,它超额完成了——毕竟中心节点只占 400MB 内存和 2G 磁盘。如果你的日志量再大十倍、需要全文检索,再考虑 ELK 不迟。
常见问题
Q:Promtail 挂了会丢日志吗?
A:短暂挂掉不丢。positions.yaml 记录了每个文件的读取偏移,重启后从断点继续。但 Loki 端有 reject_old_samples(默认 168h),停太久超过窗口的老日志会被拒收。
Q:Windows 机器的日志能收吗?
A:能,用 Promtail 的 Windows 版(Loki 官方现在推荐 Alloy 采集器,功能是 Promtail 的后继)。不过 Windows 日志是事件日志格式,配置比 Linux 麻烦不少,纯 Linux 环境体验最好。
Q:Loki 单点挂了怎么办?
A:个人场景接受单点,把 /loki 目录纳入定期备份即可恢复。真正的多副本要上 Loki 集群(ingester + S3 对象存储),成本和复杂度对个人 VPS 不划算——丢半小时日志通常可以接受,值不值这个钱自己判断。
Q:Grafana 里查不到刚打的日志?
A:按顺序查三样:Promtail 是否在推(curl http://localhost:9080/metrics 看 promtail_sent_entries)、时钟是否同步、查询的时间范围是否选对。Grafana 默认时间范围是近 1 小时,我见过不下三次「查不到」其实是范围选错。
上一篇 Prometheus 篇里说过「监控看指标、日志找现场」,这篇把后半句补齐了。两套系统共用一台 Grafana,同一个时间轴上先拉内存曲线再捞日志,定位效率比原来 ssh 三台机器分别 grep 高出一个量级。一个月用下来唯一要维护的是标签纪律:新服务接入 Promtail 时统一打 job=服务名, host=机器名 两个标签就够,克制住「把每个字段都变成标签」的冲动,基数爆炸的苦前面已经吃过了。