
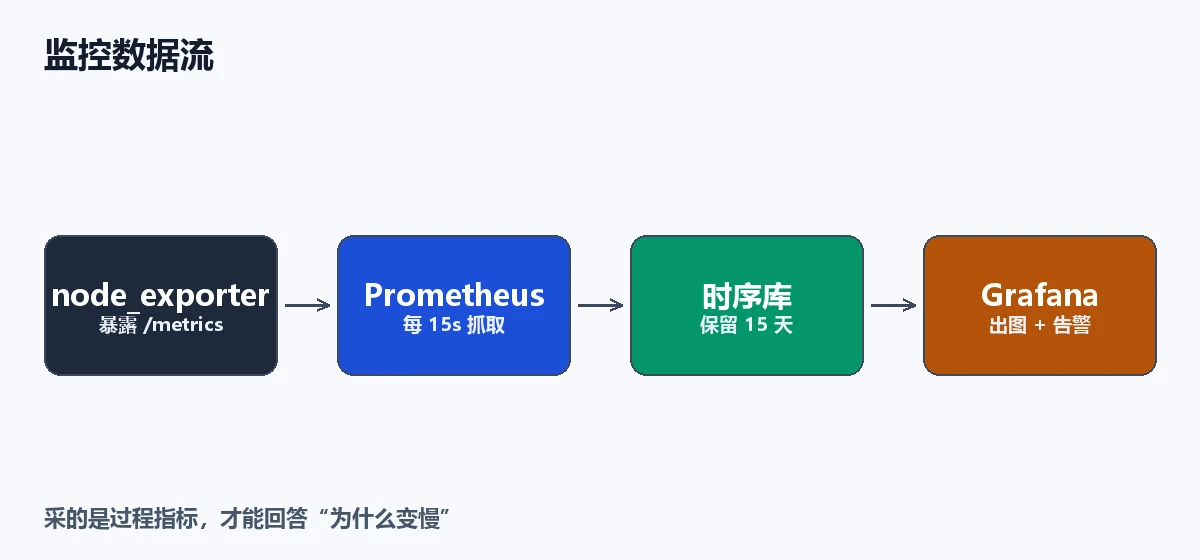
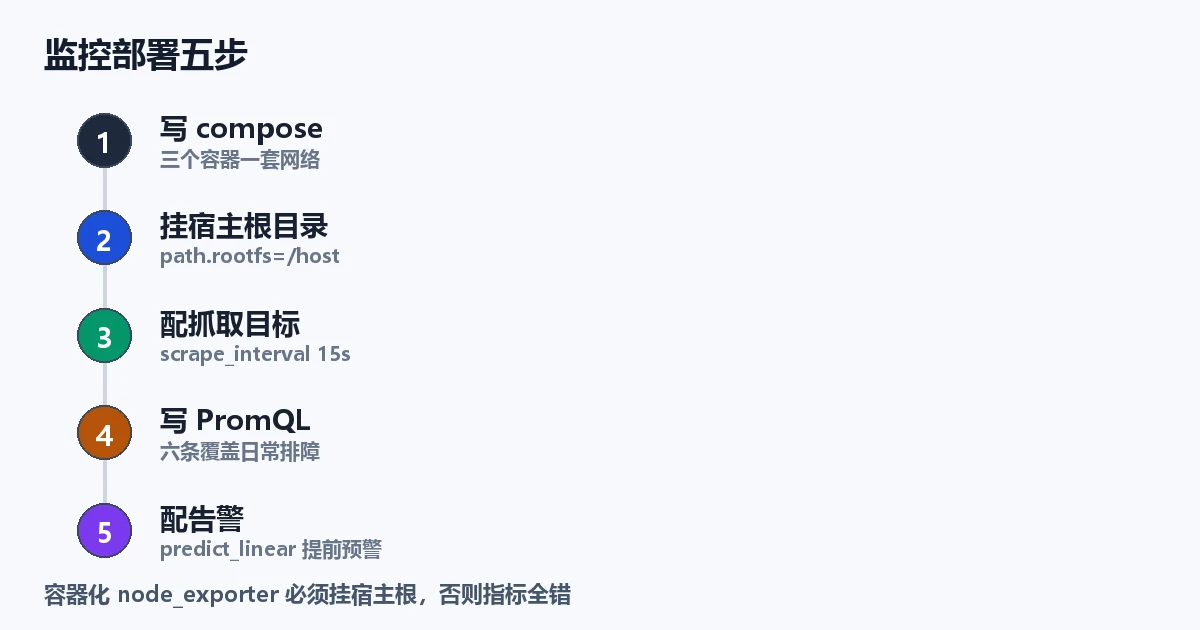
Prometheus 负责按固定间隔抓取指标并存储时序数据,node_exporter 负责把 Linux 的 CPU、内存、磁盘、网络暴露成 HTTP 接口,Grafana 负责把查询结果画成图和告警。 三者用一份 docker-compose.yml 就能在一台 2 核 4G 的机器上跑起来,常驻内存合计约 300MB。关键配置只有三处:Prometheus 的 scrape_configs 指向 node_exporter、node_exporter 必须以只读方式挂载宿主根目录、Grafana 首次登录后立刻改默认密码。2026 年 10 月这次部署的目的,是回答一个 Uptime-Kuma 答不了的问题——「每天下午三点开始变慢,到底是 CPU、内存还是磁盘 IO」。
上面是结论。上一篇写 Uptime-Kuma 时,它解决的是「服务活着吗」;这篇补上「活着但难受」那一层。
为什么有了 Uptime-Kuma 还要上 Prometheus?
结论:两者监控的对象不同——Uptime-Kuma 探的是「结果」(HTTP 是否 200、端口是否通),Prometheus 采的是「过程」(CPU 曲线、内存趋势、磁盘增长速率)。
| 维度 | Uptime-Kuma | Prometheus + Grafana |
|---|---|---|
| 数据模型 | 探测结果(up/down + 响应时间) | 多维时序指标 |
| 典型问题 | 「站点挂了吗」 | 「为什么从 15:00 开始变慢」 |
| 存储 | 自带 SQLite | 时序库,按保留期滚动删除 |
| 告警 | 内置,配置简单 | 规则表达式灵活,能算速率与同比 |
| 上手成本 | 十分钟 | 一小时 |
故障排查时最有用的是趋势。比如「内存缓慢上涨、三天后 OOM」,Uptime-Kuma 只会在 OOM 那一刻告诉你挂了,Prometheus 能让你提前两天看到斜率。
第一步:写 compose,一次起三个容器
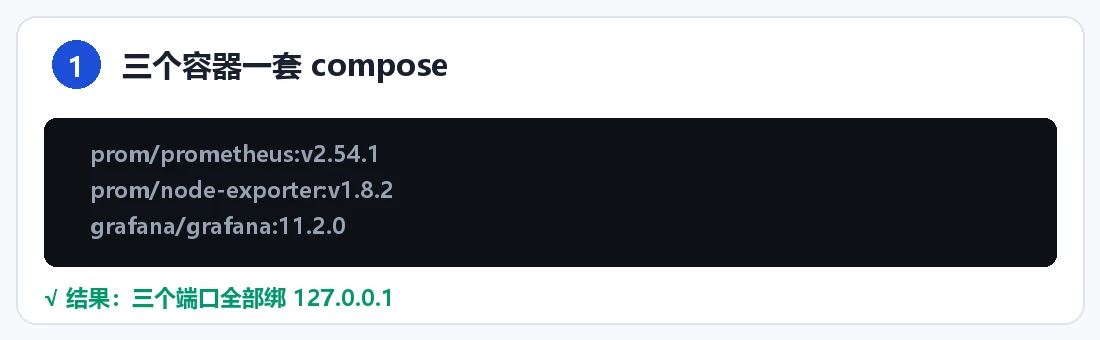
结论:三个服务放一个 compose 文件,用命名网络互通,Prometheus 通过服务名访问 node_exporter。
services:
  prometheus:
    image: prom/prometheus:v2.54.1
    container_name: prometheus
    restart: unless-stopped
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - ./rules:/etc/prometheus/rules:ro
      - prom_data:/prometheus
    command:
      - '--config.file=/etc/prometheus/prometheus.yml'
      - '--storage.tsdb.retention.time=15d'
      - '--web.enable-lifecycle'
    ports:
      - "127.0.0.1:9090:9090"

  node-exporter:
    image: prom/node-exporter:v1.8.2
    container_name: node-exporter
    restart: unless-stopped
    pid: host
    volumes:
      - /:/host:ro,rslave
    command:
      - '--path.rootfs=/host'
    ports:
      - "127.0.0.1:9100:9100"

  grafana:
    image: grafana/grafana:11.2.0
    container_name: grafana
    restart: unless-stopped
    volumes:
      - grafana_data:/var/lib/grafana
    environment:
      - GF_SECURITY_ADMIN_PASSWORD=换成你的强密码
      - GF_USERS_ALLOW_SIGN_UP=false
    ports:
      - "127.0.0.1:3000:3000"

volumes:
  prom_data:
  grafana_data:
三个端口全部绑 127.0.0.1,公网访问统一走 Nginx 反代。Grafana 千万别直接开在公网 3000 端口——它是整套系统里唯一有登录态的东西,暴露出去等于把监控数据送人。
第二步:确认 node_exporter 采到的是「宿主」而不是容器
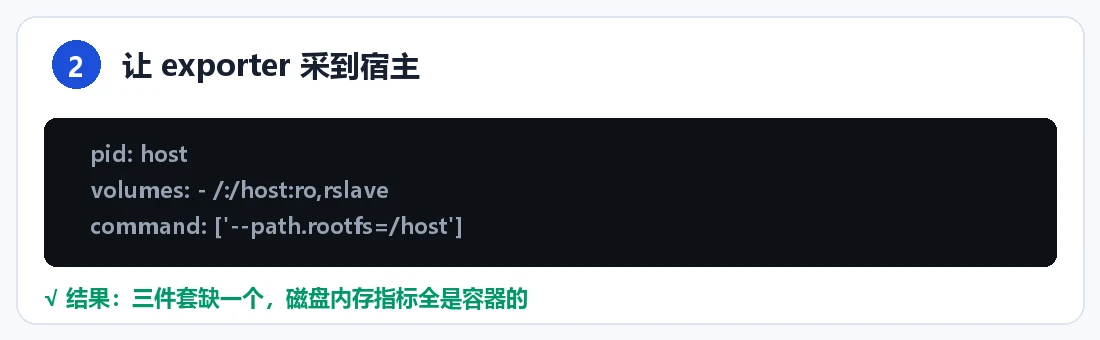
结论:容器里的 node_exporter 默认只看得到容器自身的命名空间,必须挂载宿主根目录并指定 --path.rootfs,否则磁盘和内存指标全是错的。
这是本篇最重要的一个坑。我第一次部署时 compose 里只写了 image,没挂 /,结果 Grafana 上磁盘使用率死死停在 12%——那是容器可写层的使用率,不是宿主 40G 盘的 87%。
两个参数缺一不可:
    pid: host                    # 让采集器看到宿主的进程与网络命名空间
    volumes:
      - /:/host:ro,rslave        # 只读挂载宿主根,rslave 保证传播
    command:
      - '--path.rootfs=/host'    # 告诉 exporter 去哪里读 /proc 和 /sys
验证采集结果:
$ curl -s http://127.0.0.1:9100/metrics | grep 'node_filesystem_size_bytes{mountpoint="/"'
node_filesystem_size_bytes{device="/dev/vda1",fstype="ext4",mountpoint="/"} 4.2148e+10
4.2e10 约等于 40G,说明读到的是宿主盘。如果这个值是几 GB 甚至几 MB,就是挂载没生效。
pid: host 影响的是 node_processes_* 这类指标——不加的话你看到的是容器内的进程数,永远是 3 个左右,没有任何参考价值。
第三步:配置抓取目标与保留期
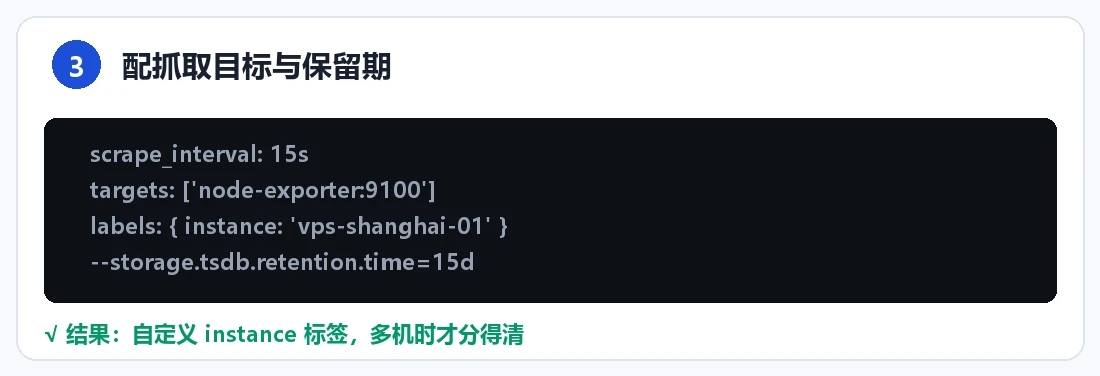
结论:prometheus.yml 里一个 job 指一个 exporter,抓取间隔 15 秒对单机足够,保留期按磁盘容量倒推。
prometheus.yml:
global:
  scrape_interval: 15s
  evaluation_interval: 15s

rule_files:
  - /etc/prometheus/rules/*.yml

scrape_configs:
  - job_name: 'node'
    static_configs:
      - targets: ['node-exporter:9100']
        labels:
          instance: 'vps-shanghai-01'

  - job_name: 'prometheus'
    static_configs:
      - targets: ['localhost:9090']
instance 标签是自定义的——默认会是 node-exporter:9100 这种容器名,多台机器时完全分不清谁是谁。加上可读的名字,后面告警文案里直接用得上。
保留期在启动参数里:--storage.tsdb.retention.time=15d。粗算磁盘占用:单个指标每 15 秒一个点,约 1–2 字节压缩后;node_exporter 大概 800–1200 个活跃序列,15 天大约 200–400MB。40G 的机器留 15 天比较合适,512MB 内存的小机器建议降到 7 天。
改完配置热加载(因为开了 --web.enable-lifecycle):
$ curl -X POST http://127.0.0.1:9090/-/reload
配置语法参考 Prometheus 官方配置文档。
第四步:六条能直接用的 PromQL
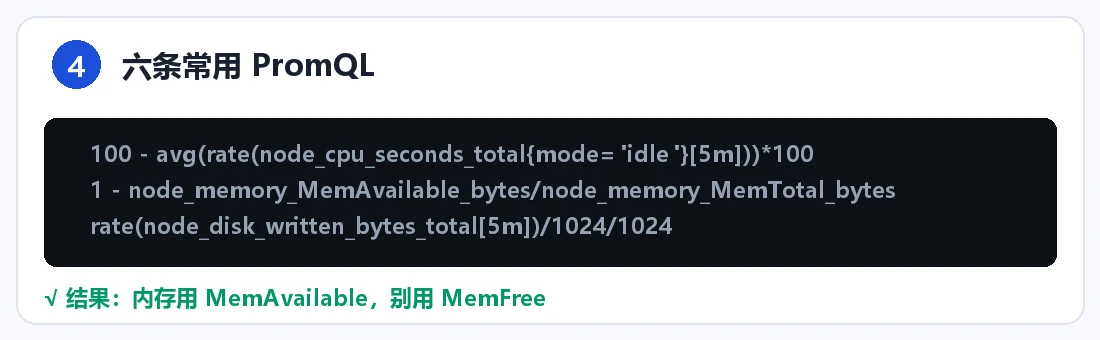
结论:日常排障 90% 的问题用这六条查询就能定位,全部可以在 Prometheus 的 Graph 页面直接粘。
CPU 使用率:
100 - (avg by(instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100)
内存使用率(用 MemAvailable 而不是 MemFree,后者把缓存算成已用,会吓死人):
(1 - node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes) * 100
根分区剩余百分比:
node_filesystem_avail_bytes{mountpoint="/"} / node_filesystem_size_bytes{mountpoint="/"} * 100
磁盘写入速率(MB/s):
rate(node_disk_written_bytes_total{device="vda"}[5m]) / 1024 / 1024
网络出向带宽(Mbps):
rate(node_network_transmit_bytes_total{device="eth0"}[5m]) * 8 / 1000000
系统负载(1 分钟):
node_load1
node_load1 单独看没意义,要和核数比。2 核机器负载持续大于 2 就是过载。我把它和 CPU 使用率放在同一张图里,一眼能看出是「真算不过来」还是「IO 阻塞导致的假高负载」——后者 CPU 不高但负载高,通常意味着磁盘或网络在拖。
第五步:配两条真正会响的告警
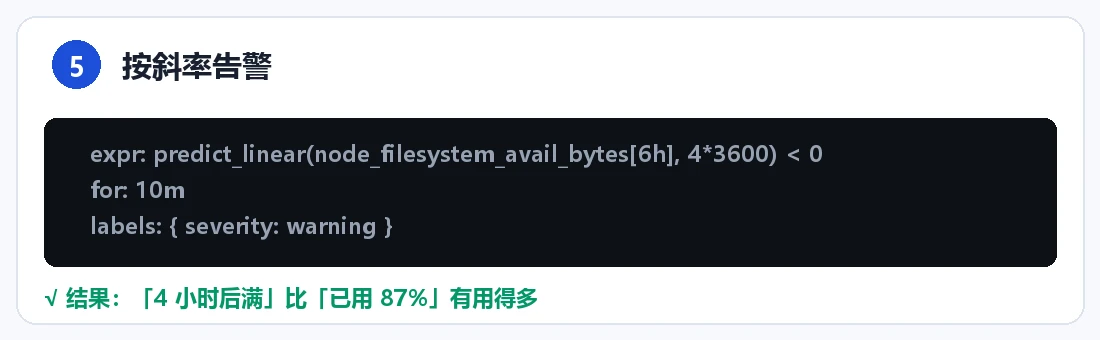
结论:告警宁少勿多,先配「磁盘将满」和「内存将满」两条,误报率低、价值高。
groups:
  - name: host-basic
    rules:
      - alert: DiskWillFillIn4Hours
        expr: predict_linear(node_filesystem_avail_bytes{mountpoint="/"}[6h], 4*3600) < 0
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "根分区预计 4 小时内写满"
          description: "实例 {{ $labels.instance }} 当前可用 {{ $value | humanize }}B"

      - alert: MemoryHigh
        expr: (1 - node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes) * 100 > 90
        for: 15m
        labels:
          severity: warning
        annotations:
          summary: "内存使用率超过 90% 持续 15 分钟"
predict_linear 是这套系统里最有价值的一个函数——它按最近 6 小时的斜率推算 4 小时后还剩多少空间。「磁盘 87%」不会告警,「磁盘按当前速度 3 小时后满」才会。 前者是噪音,后者是要行动的信号。
告警接收端可以直接用 Grafana 的 Alerting 配飞书 Webhook,不必再单独部署 Alertmanager——单机场景多一个组件就多一处会坏的地方。具体做法是在 Grafana 里建一个 Contact point,类型选 Webhook,把飞书机器人的地址填进去,然后在 Alert rule 里引用它。飞书自定义机器人要求 POST 体是 {"msg_type":"text","content":{"text":"..."}},Grafana 默认的模板不是这个格式,需要在 Contact point 的 Message 里手写模板。这一步有点绕,但只要配通一次就能一直用。
不过也有代价:Grafana 的告警状态和图表在同一个进程里,Grafana 挂了告警也就哑了。如果告警本身是刚需(比如这台机器上跑着收款接口),还是老老实实上 Alertmanager,让它独立于可视化层。我的判断标准是「告警延迟十分钟会不会造成实际损失」——不会就用 Grafana 自带的,会就上 Alertmanager。
踩过的四个坑
结论:容器化 node_exporter 的挂载、Grafana 默认密码、时间同步、保留期,这四个是最常见的翻车点。
坑一:node_exporter 采到容器指标。 见第二步,pid: host + --path.rootfs=/host + 挂载 / 三件套缺一不可。
坑二:Grafana 默认 admin/admin。 第一次登录会强制改密码,但如果你的 3000 端口开着公网,从启动到改密码这几分钟就是敞开的窗口。用 GF_SECURITY_ADMIN_PASSWORD 环境变量直接设。
坑三:容器时区和宿主不一致。 Grafana 图表按浏览器时区显示,但 Prometheus 存的是 UTC 时间戳,一般没问题;真正出错的是告警文案里的时间。给三个容器都加 TZ=Asia/Shanghai。
坑四:保留期设太长把盘写满。 默认 15d,但如果指标基数大(多实例、多磁盘、多网卡),实际占用会翻几倍。上线一周后 du -sh /var/lib/docker/volumes/*prom* 看一眼真实体积,再决定要不要缩短。
常见问题
Q:和 Netdata 比,Prometheus 是不是太重了?
A:Netdata 装完就有图,零配置,单机体验更好。Prometheus 的优势是多机聚合、查询语言灵活、能和现有告警体系对接。只有一台机器且不想折腾,Netdata 更划算。
Q:2 核 4G 跑这三个够吗?
A:够。实测常驻内存 Prometheus 约 150MB、Grafana 约 120MB、node_exporter 约 20MB,CPU 基本空闲。抓取间隔从 15s 调到 30s 还能再省一半。
Q:能不能监控容器级别的 CPU 和内存?
A:可以,加 cadvisor 容器(gcr.io/cadvisor/cadvisor),抓 8080 端口,然后用 container_cpu_usage_seconds_total 这类指标。但它本身占资源较多,小机器上按需加。
Q:数据能不能长期保留?
A:本地时序库不适合长期存。要长期留存就接 Thanos 或 VictoriaMetrics,或者定期把关键指标导出成 CSV。单机场景 15 天足够定位问题。