
应用进程没有任何报错就消失,SSH 也卡了几分钟才连上,这是内核 OOM killer 的标准现场:内存和 swap 都耗尽时,内核按 oom_score 挑一个进程杀掉自保,应用层日志里不会留下任何痕迹。确认手段只有一条路,看内核日志 dmesg。 2026 年 10 月,我一台 2G 内存的监控机在凌晨连续两天被杀进程,这篇把排查过程按时间线完整还原。
上一篇在算镜像体积的账,这篇的机器也和「省」有关:2G 内存跑了 Prometheus、Grafana 和几个采集器,为了省钱没配 swap。Dify 那篇实测过向量化冲高会吃 1G,这台机器上冲高的是 Grafana 导出报表,两天的日志里答案写得清清楚楚,只是我第一天没看对地方。
第一步:确认是 OOM,别急着重启
结论:dmesg -T | grep -i "killed process" 是唯一权威确认手段,看到 "Out of memory: Killed process" 这行,OOM 实锤。
$ sudo dmesg -T | grep -i "killed process" | tail -5
[Tue Oct 22 03:12:44 2026] Out of memory: Killed process 18512 (grafana) total-vm:2684032kB, anon-rss:1892216kB, shmem-rss:0kB, UID 472 pgtables 3964kB oom_score_adj:0
这行日志每个字段都有用:
| 字段 | 值 | 解读 |
|---|---|---|
| 时间戳 | 03:12:44 | 凌晨,说明有周期性任务在冲高 |
| 进程名/PID | grafana / 18512 | 被杀的是 Grafana,未必是真凶 |
| anon-rss | 1892216kB ≈ 1.8G | 被杀瞬间它占的物理内存 |
| oom_score_adj | 0 | 无人工干预,纯内核评分 |
关键认知:OOM killer 杀的是 oom_score 最高的进程,那个进程常常只是「当时最肥」,不一定是漏内存的真凶。我的案例里 Grafana 被杀,但持续上涨的真凶是另一个采集器。
第二步:找真凶,看历史而不是看现场
结论:事后 ps 看到的是「现在」,真凶可能已经被杀或回落,要用 sar 或监控的历史曲线看事发时段。
这台机器装了 node_exporter(监控篇里配的),Grafana 里直接拉事发前两小时的内存曲线:凌晨 3 点整一条线垂直拉升,时间点和 crontab 里一个报表导出任务完全吻合。没有监控历史的机器用 sar 补:
$ sar -r -f /var/log/sysstat/sa22    # 看 22 号的历史内存
$ sar -r | tail -20                  # 今天的采样
当时抓了个现行:手动触发那个导出任务,另开终端 watch -n 2 "ps aux --sort=-rss | head -8",看到导出子进程的 RSS 在 40 秒内从 80MB 涨到 1.2G,报表全量拉取没分页,内存里攒了整份结果集。
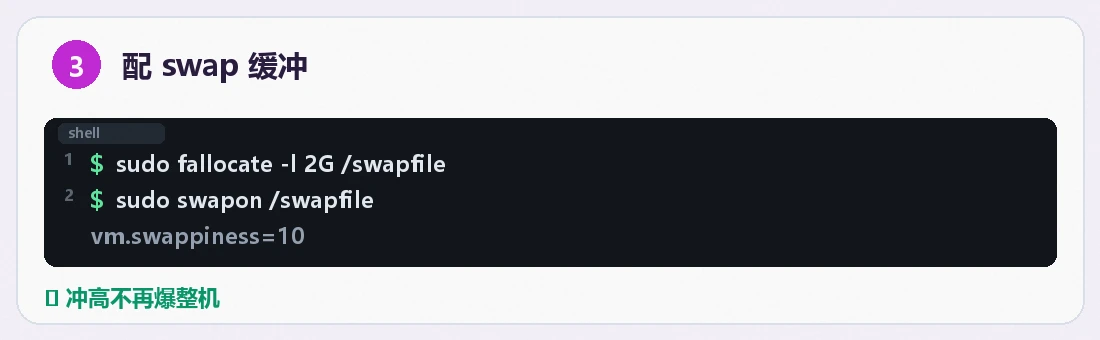
第三步:swap 与 swappiness,数据库机器例外
结论:小内存机器配 1–2G swap 是 OOM 的缓冲垫,vm.swappiness=10 让内核尽量不碰它;跑数据库的机器反过来,该高 swap 该禁就禁。
$ sudo fallocate -l 2G /swapfile
$ sudo chmod 600 /swapfile && sudo mkswap /swapfile && sudo swapon /swapfile
$ echo '/swapfile none swap sw 0 0' | sudo tee -a /etc/fstab
$ sudo sysctl vm.swappiness=10
我的取舍:这台是监控机,Grafana 卡两秒无所谓,swap 是纯赚。数据库机器不同,MySQL 那篇写过 binlog 恢复,数据库页被换出去再换回来的代价远大于直接 OOM 重启,那种机器的正确做法是限死各服务内存加足够的物理内存,swap 只留几百 MB 应急。
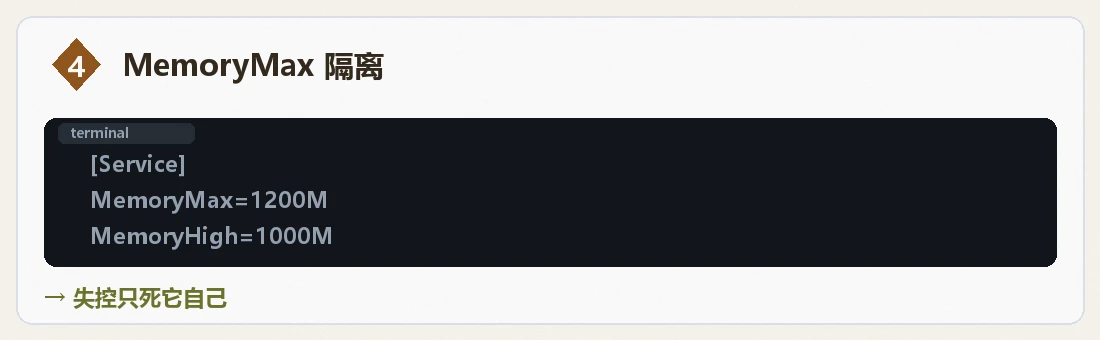
第四步:systemd MemoryMax,把故障域圈住
结论:给每个大服务加 MemoryMax 硬上限,单个服务失控时被杀的是它自己,整机和其他服务安然无恙。
$ sudo systemctl edit grafana-server.service
写入:
[Service]
MemoryMax=1200M
MemoryHigh=1000M
MemoryHigh 到线后内核开始回收该服务的页缓存并压速,MemoryMax 到线直接触发该服务自己的 OOM(cgroup 级),范围只在这个服务。实测再跑那个失控报表,被杀的是 Grafana 自己的导出子进程,Prometheus 和采集器全程无感,SSH 不卡,这就是故障域隔离的价值。systemd 资源控制文档在 freedesktop.org。
第五步:告警前置,让 OOM 在发生前 30 分钟被看见
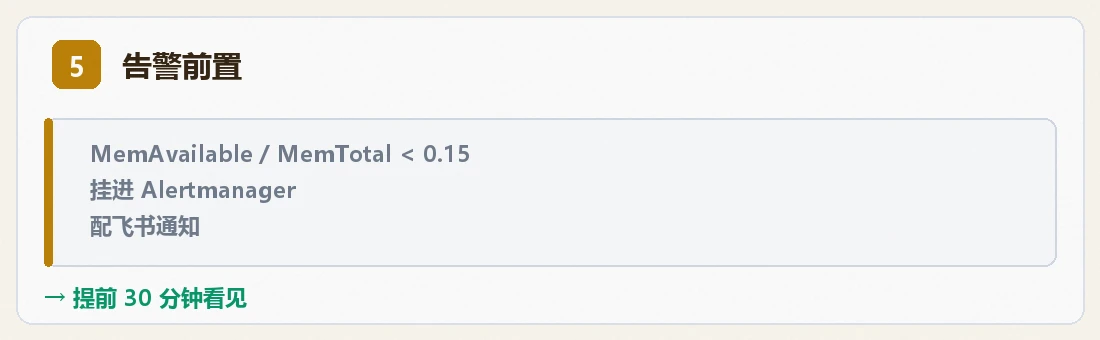
结论:盯 MemAvailable 不盯 MemFree,Prometheus 规则在可用内存跌破 15% 时告警,多数 OOM 在发生前有半小时的爬升期。
(node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes) < 0.15
PromQL 挂进 Alertmanager,配合之前监控篇的飞书告警通道。MemAvailable 才是真实可用量,它算上了可回收的页缓存,MemFree 看起来很小其实是缓存在撑着,误报源头多在这。
为什么三道防线缺一不可?
结论:修代码(分页拉取)、配 swap(缓冲)、加 MemoryMax(隔离),三道防线各管一段,只做任何一道都挡不住下一次。
真凶最后是代码问题:报表导出全量拉取改成游标分页,单次内存占用从 1.2G 降到 90MB,这个修掉之后两天没再出事。但我不敢赌代码永远没 bug,swap 和 MemoryMax 留着,它们防的是下一个我不知道的失控进程。
同机部署的另一个教训:Prometheus 自己的保留期也会吃内存和磁盘,--storage.tsdb.retention.time=15d 把保留期从默认 15 天压到实际需要的长度,监控机自己先做到不失控,才有资格盯着别人。
官方 OOM 相关内核文档在 kernel.org,oom_score 计算规则也在其中。
容器里的 OOM:判定口径和宿主机不一样
结论:容器进程被杀先看 docker inspect 的 OOMKilled 字段,cgroup 内的 OOM 只死容器自己,别和宿主机 OOM killer 混为一谈。
宿主机 OOM 和容器 OOM 是两套判定:前者看整机内存耗尽、按全局 oom_score 挑人;后者看容器自己的 cgroup 限额,超了就在 cgroup 内部解决,dmesg 里会多一行 Memory cgroup out of memory。排查动作也不同:
$ docker inspect myapp --format '{{.State.OOMKilled}} {{.State.ExitCode}}'
true 137
ExitCode 137 加 OOMKilled=true,是容器被 cgroup 杀掉的标准组合。我的监控机是裸机 systemd 服务,用 MemoryMax;Docker 化的服务则用 compose 里的 mem_limit/memswap_limit,两条路最后都落到同一个 cgroup 机制上。dify 那篇给容器划内存的实测就走的这条路,边界划清楚之后,「谁失控谁死」这条原则在两种部署形态下都成立。
官方内核文档对全局与 cgroup OOM 的差异写在 kernel.org 的 cgroup 一节,oom_score 计算规则也在其中。
常见问题
Q:OOM killer 能不能关掉?
A:能(sysctl vm.panic_on_oom 等),但生产机器上关掉等于把「杀一个进程」升级成「整机卡死或 panic」,几乎永远是更坏的选择。正确思路是圈住故障域。
Q:怎么保护关键进程不被杀?
A:echo -1000 > /proc/<pid>/oom_score_adj,sshd 这类保命进程可以设。别对大内存服务滥用,真耗尽了总要杀点什么,保护了 A 就会杀 B。
Q:Docker 容器内存怎么限?
A:docker run -m 1g 或 compose 里 mem_limit,超限是 cgroup OOM,docker inspect 看 OOMKilled 字段确认。Dify 那篇的调优同理适用。
Q:为什么会选 Grafana 而不是真凶?
A:oom_score 综合考虑内存占用和 oom_score_adj,Grafana 长驻 1.8G 自然评分最高。内核只负责「让系统活着」,不负责公平。
Q:事后只看日志行不行,监控可以不装吗?
A:这次能定位真凶,靠的是事发时段的内存曲线,没有历史就只能靠猜。日志能告诉你「谁被杀了」,只有带历史的监控能告诉你「谁一直在涨」。装 node_exporter 的时间成本是十分钟,值。
如果重来一次,先做哪一步?
结论:先装监控再看日志——没有历史曲线的排障,一半时间花在猜上。
这台机器是被杀过两次之后我才补上 node_exporter 的,如果顺序倒过来,第一次就能从曲线里看到爬升段,省掉一整晚的复现等待。三道防线的落地顺序也值得记:swap 十分钟、MemoryMax 十五分钟、代码分页改了半天——先做便宜且通用的,再做针对这个 bug 的修复。上一篇镜像瘦身的思路在这里同样成立:先把结构性问题(额度、上限、隔离)一次性配齐,单次故障才不会升级成事故。