
用着 ChatGPT、又想试试 Claude 和几家的国产模型,很快就会发现一件事:每个 SDK、每个 key、每套计费口径都不一样,代码里到处是 if provider == ...。
new-api 解决的就是这个:它把一堆上游模型渠道,汇聚成一个 OpenAI 兼容的接口。你的客户端只认一个 BASE_URL + 一个 key,背后换了哪家供应商,代码一行都不用改。
聚合的价值在哪
- 一个接口统一所有模型:换供应商、加新模型,客户端无感;
- 统一额度与限流:给不同的下游令牌分配额度、设分组,防止单 key 被刷爆;
- 渠道故障切换:某家上游挂了,自动切到备用渠道;
- 用量统计:谁用了多少、花了多少,面板上一目了然。
数据流向
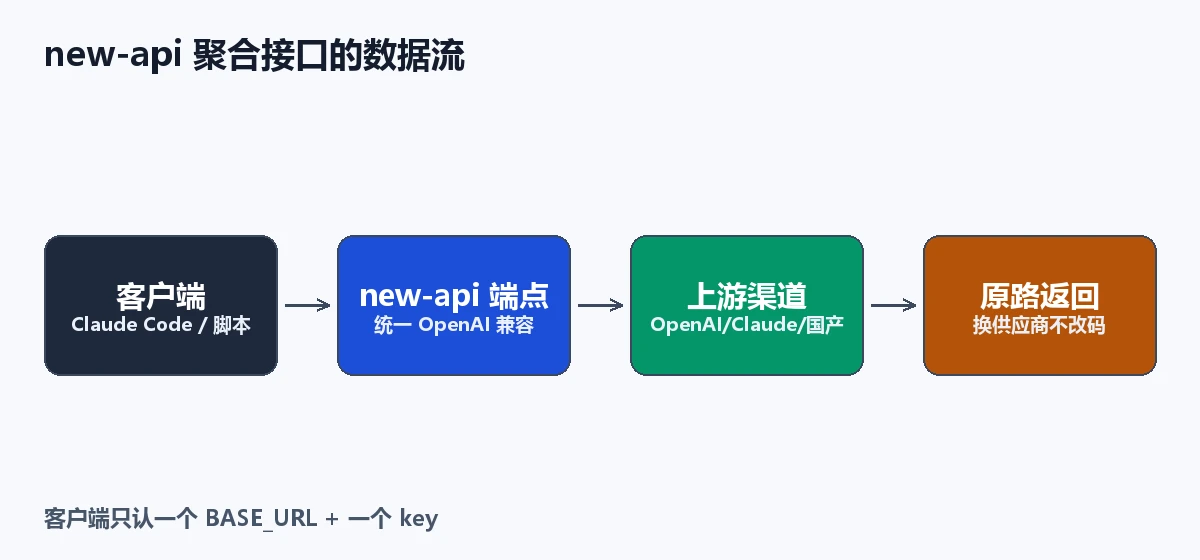
客户端(Claude Code、脚本、任意 OpenAI 兼容工具)→ new-api 统一端点 → 按模型路由到不同上游渠道(OpenAI / Anthropic / Gemini / 国产模型)→ 结果原路返回。
操作步骤速览
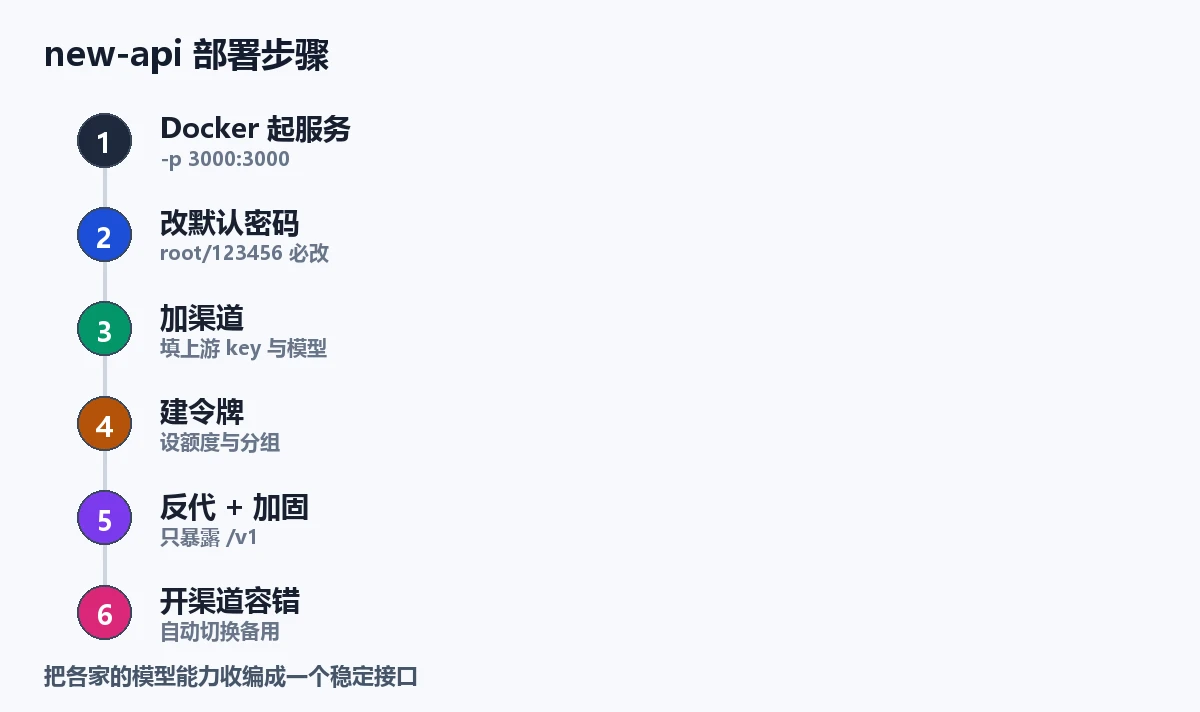
一、Docker 起服务
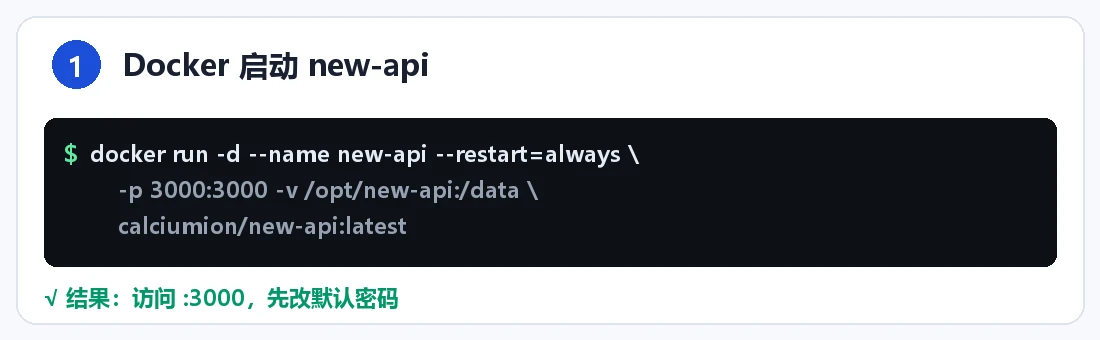
$ docker run -d --name new-api --restart=always \
    -p 3000:3000 \
    -v /opt/new-api:/data \
    calciumion/new-api:latest
访问 http://服务器IP:3000。默认账号 root / 密码 123456——登进去第一件事就是改密码,这是明牌口令,公网裸奔等于送人。
二、加渠道:把各家 key 塞进来
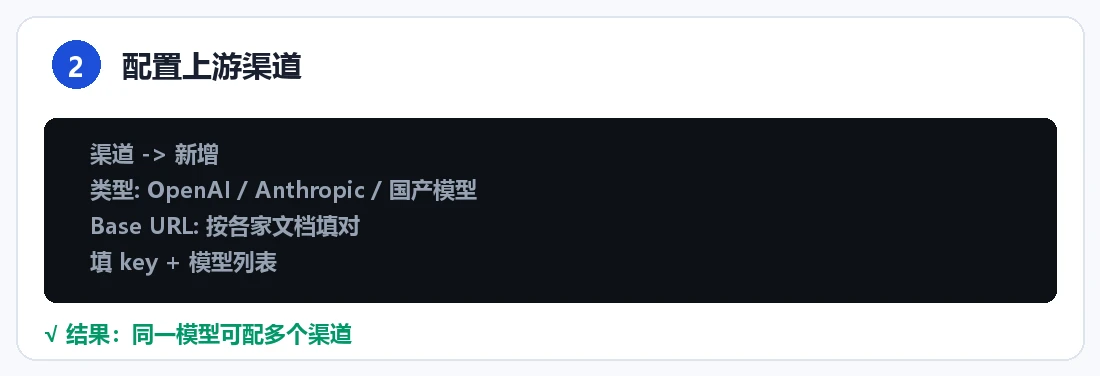
面板 →「渠道」→ 新增渠道:
- 类型:选上游种类(OpenAI / Anthropic / Gemini / 各种国产模型);
- 上游地址(Base URL):注意——很多"OpenAI 兼容"的国产模型 base 地址各不相同,要按各家文档填对;
- 密钥:填该家的 key;
- 模型列表:填这个渠道要开放的模型名。
同一个模型可以配多个渠道,后面就能做负载均衡和故障切换。
三、建令牌,分配给客户端
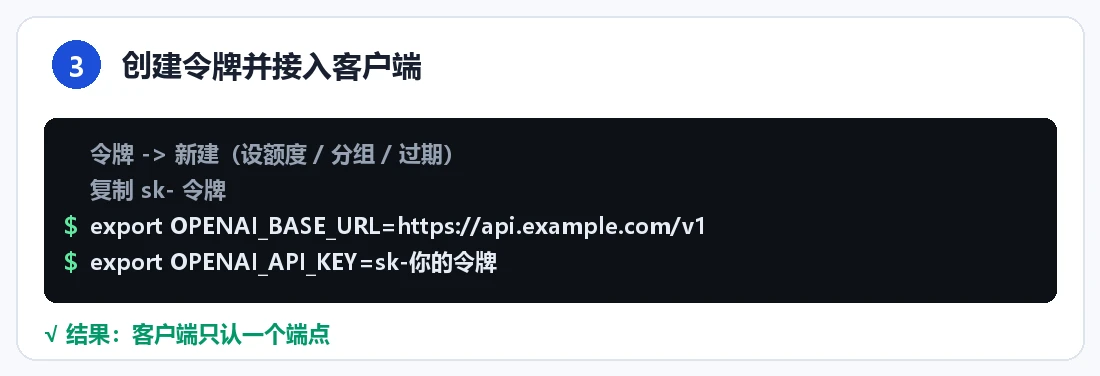
面板 →「令牌」→ 新建:
- 设额度上限、过期时间、可用分组;
- 复制生成的
sk-...令牌。
然后把地址和令牌给客户端(以 OpenAI 兼容用法为例):
$ export OPENAI_BASE_URL="https://api.example.com/v1"
$ export OPENAI_API_KEY="sk-你的令牌"
Claude Code 之类的工具同理,只要把 ANTHROPIC_BASE_URL 指向 new-api 的 Anthropic 兼容端点即可。
四、反代 + 加固
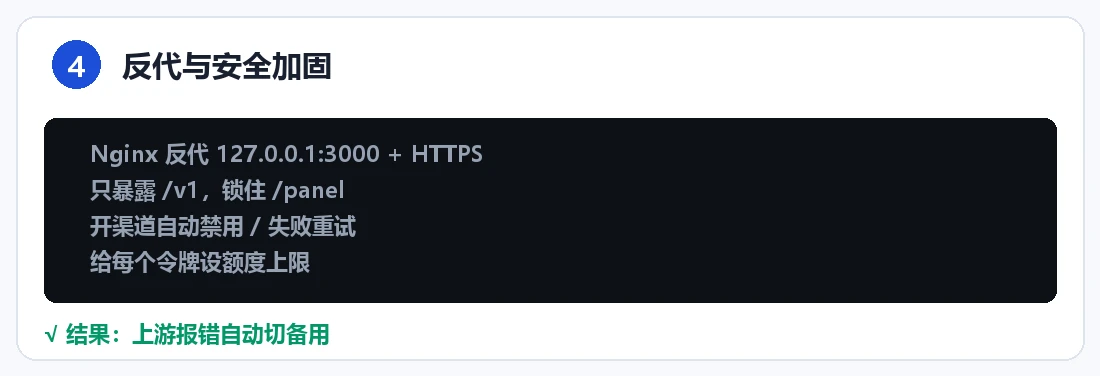
- 反代:Nginx 把
api.example.com反代到127.0.0.1:3000,开 HTTPS; - 锁面板:
/panel路径加 Basic Auth 或限制来源 IP,只把/v1暴露给客户端; - 渠道容错:开启渠道自动禁用 / 失败重试,上游报错自动切备用;
- 额度兜底:给每个令牌设额度上限,单个 key 被刷爆也只损失设定值。
三个常见的坑
- 默认口令不改:
root / 123456是全网都知道的,公网入口必须第一时间改掉,并给面板加访问保护。 - 上游 base 地址填错:很多国产模型虽"OpenAI 兼容",但 base 路径不同(有的要带
/v1,有的不带)。渠道测试不通,先怀疑这里。 - 面板暴露在前端:正确姿势是只暴露
/v1给客户端,管理面板要么锁 IP、要么加认证,别让/panel裸奔。
小结
new-api 的价值不在于"多了一个管理面板",而在于把散落在各家的模型能力收编成一个稳定接口——上游怎么变,下游都不用动。
对同时用 Claude Code、脚本、又想在多家模型间横向比较的人,这一步几乎是必做的基础设施:先有统一入口,才谈得上灵活换模型、控成本、看用量。
常见问题
new-api 和 one-api 是什么关系?
new-api 是 one-api 的活跃分支,界面与功能更现代,兼容 one-api 的渠道与数据格式;已有的 one-api 数据可以直接迁移过来。
聚合接口安全吗?
关键看部署。别把上游 key 明文暴露到前端;用令牌(token)分配额度、设分组与限流,并给面板加访问保护,这样即使某个下游 key 泄露,损失也可控。