
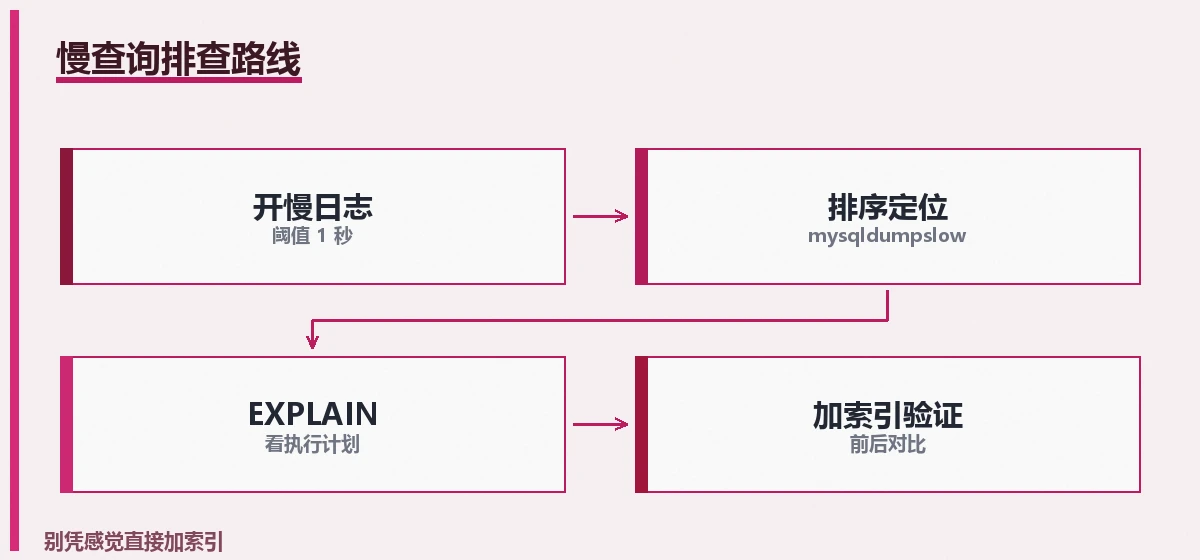
接口变慢的排查顺序是固定的:先开慢查询日志抓现行,再用 mysqldumpslow 按总耗时排序锁定 SQL,然后 EXPLAIN 看执行计划找原因,最后改完必须重跑 EXPLAIN 对比验证。跳过任何一步直接「凭感觉加索引」,大概率白干。 2026 年 10 月 24 日下午,我管理的 WordPress 站(就是 Redis 对象缓存那篇的同款架构)接口从 80ms 涨到 4 秒,这篇按时间线还原三个小时的排查,所有数字来自现场记录。
上一篇写了 OOM 的深夜排障,这篇是白天的数据库排障,两篇合起来正好覆盖「突然变慢」最常见的两个源头:内存和查询。
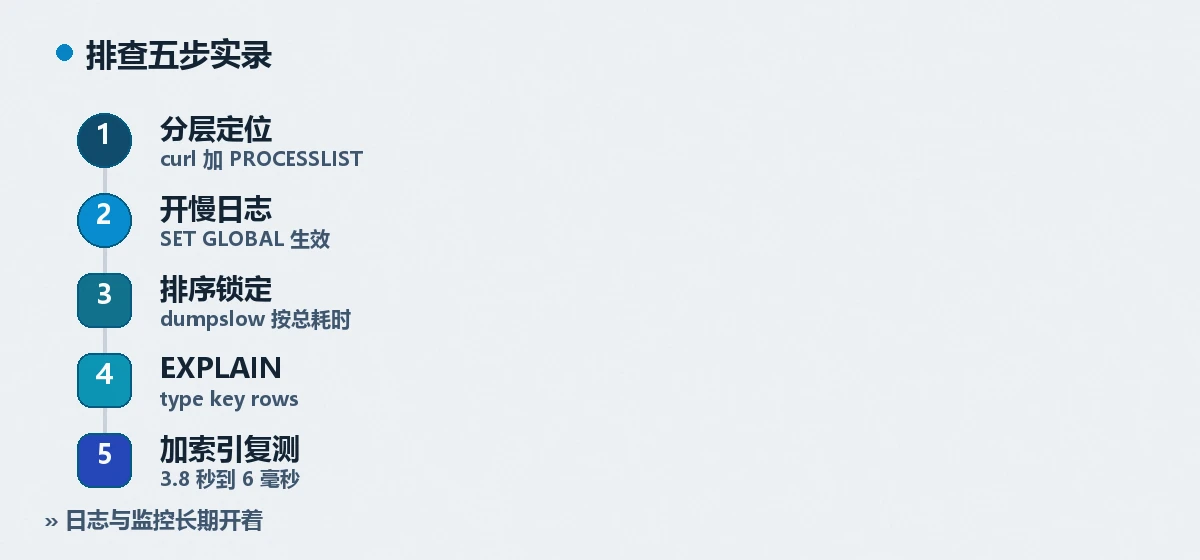
14:05 确认现象:是数据库慢,不是别的慢
结论:先分层定位,curl 计时 + 后台查 SHOW PROCESSLIST,30 秒内确认锅在 MySQL,别一上来就重启。
$ curl -o /dev/null -s -w "TTFB: %{time_starttransfer}s\n" https://pddpdd.cn/
TTFB: 4.213s
$ mysql -e "SHOW FULL PROCESSLIST;" | grep -v Sleep
| 8812 | db_user | ... | Query | 3 | Sending data | SELECT ... FROM wp_postmeta ... |
TTFB 4.2 秒,PROCESSLIST 里挂着一条 3 秒的 wp_postmeta 查询,初步锁定数据库。这时候最容易犯的错是重启 MySQL:重启清掉现场,问题过两小时又来,白折腾。
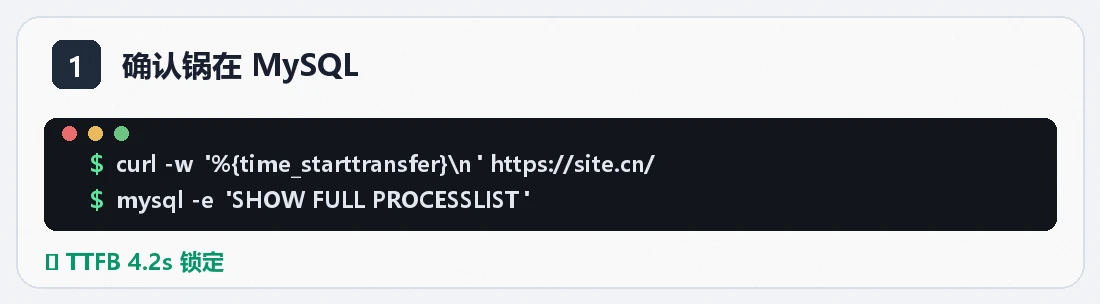
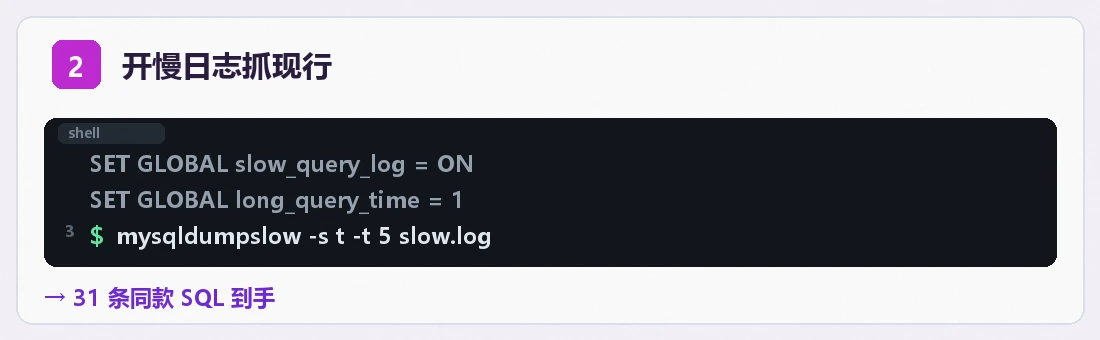
14:15 开慢查询日志,抓现行
结论:SET GLOBAL 动态开启不用重启,long_query_time 降到 1 秒,再开 log_queries_not_using_indexes 抓漏网之鱼,跑半小时足够。
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 1;
SET GLOBAL log_queries_not_using_indexes = 'ON';
SHOW VARIABLES LIKE 'slow_query%';
半小时后 slow.log 里有 47 条记录,用 mysqldumpslow 排序:
$ mysqldumpslow -s t -t 5 /var/log/mysql/slow.log
Count: 31  Time=3.8s (117s)  Lock=0s  Rows=12
  SELECT post_id, meta_value FROM wp_postmeta WHERE meta_key = 'S' ...
31 条同样的查询占了 117 秒总耗时,真凶到手:一条按 meta_key 查 wp_postmeta 的语句,每天被主题模板调用几百次。表有 21 万行,查询却扫了全表。
15:00 EXPLAIN 看执行计划,锁定索引缺失
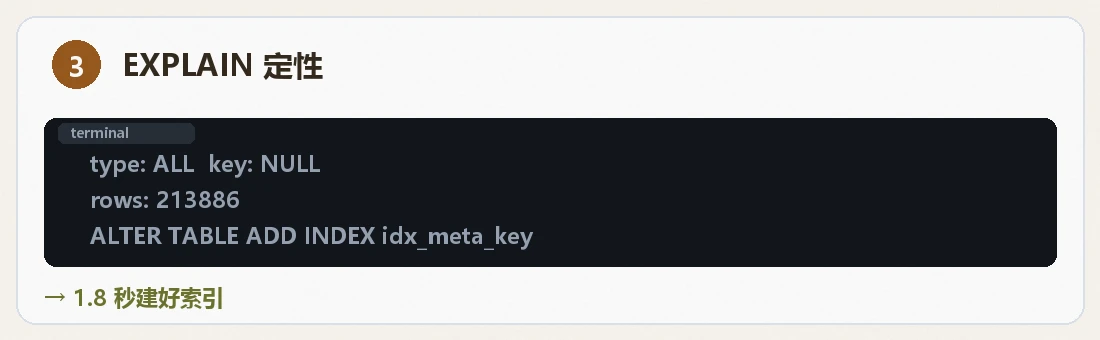
结论:type=ALL 是全表扫描,key=NULL 是没走索引,Extra 里的 Using filesort 是排序没吃到索引,三个信号对应三种修法。
EXPLAIN SELECT post_id, meta_value FROM wp_postmeta
WHERE meta_key = '_thumbnail_id';
-- type: ALL | key: NULL | rows: 213886 | Extra: Using where
21 万行全扫,返回 12 行,典型的索引缺失。wp_postmeta 表结构看过之后发现 meta_key 列根本没有索引(WordPress 默认只在 post_id 上有主键)。MySQL 手册对 EXPLAIN 输出的完整解释在 dev.mysql.com/doc。
顺手又踩到一个隐藏问题:另一条查询 WHERE meta_key = 12345(数字字面量)和 WHERE meta_key = '12345'(字符串)行为不同,meta_key 是 VARCHAR,数字比较触发隐式类型转换,索引直接作废。这类问题在 EXPLAIN 里表现为「索引明明在却不走」,文档里没有醒目提示,属于线上踩过才记得的坑。
15:30 加索引,先在从库验证再上主库
结论:ALTER TABLE 加索引前先跑 EXPLAIN 确认设计有效,21 万行的表加索引锁表时间实测 1.8 秒,挑流量低谷执行。
ALTER TABLE wp_postmeta ADD INDEX idx_meta_key (meta_key);
-- Query OK, 0 rows affected (1.82 sec)
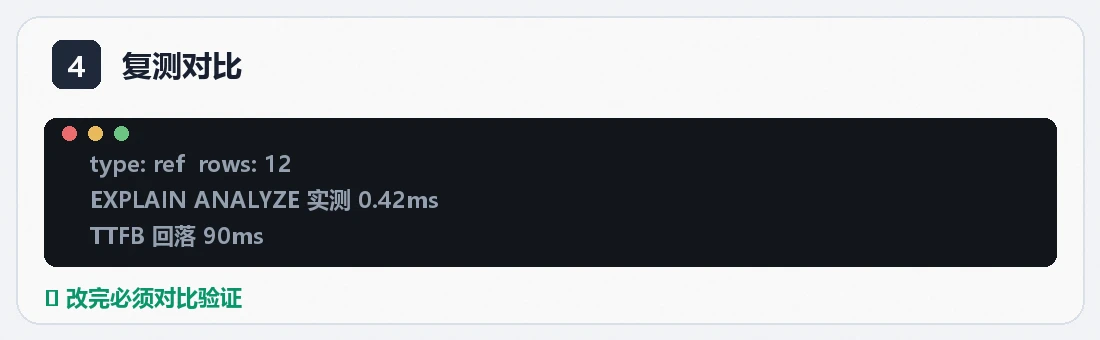
加完立刻重跑 EXPLAIN 对比:
| 指标 | 加索引前 | 加索引后 |
|---|---|---|
| type | ALL | ref |
| key | NULL | idx_meta_key |
| rows | 213886 | 12 |
| 实测耗时 | 3.8s | 6ms |
rows 从 21 万降到 12,接口 TTFB 回落到 90ms。MySQL 8.0.18 以上可以用 EXPLAIN ANALYZE 拿真实执行耗时(不只是估算),验证更硬:
EXPLAIN ANALYZE SELECT post_id FROM wp_postmeta WHERE meta_key = '_thumbnail_id';
-- actual time=0.15..0.42 rows=12  (真实数字,非估算)
16:00 收尾:把日志留着,把监控补上
结论:慢查询日志降回 2 秒阈值长期开着,每月看一眼;索引不是越多越好,写多的表每个索引都在拖慢写入。
三个收尾动作:
long_query_time调回 2 秒长期开着,日志开销在阈值 1 秒以上时可忽略。- 查了一遍 wp_postmeta 现有索引,确认没有重复索引浪费写入开销。
- 把
SHOW GLOBAL STATUS LIKE 'Slow_queries'加进监控看板,突增即告警。
漏掉的第四件事差点酿成二次事故:当天晚上另一批查询又慢了,这次是缓存预热任务和统计脚本同时跑,锁等待叠加。 SHOW ENGINE INNODB STATUS 里的锁段确认后,错峰了两个任务。数据库慢不总是一个原因,修完一个别急着宣布结案。
为什么索引明明存在却不被使用?
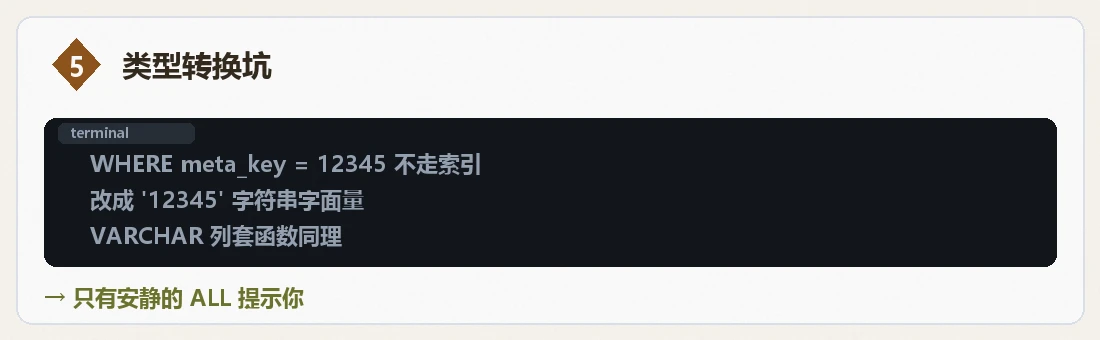
结论:VARCHAR 列和数字比较、索引列套函数、最左前缀不满足、LIKE 以 % 开头,四种写法都会让索引失效,前两种最隐蔽。
现场例子:
-- meta_key 是 VARCHAR,这条不走索引(隐式转换)
SELECT * FROM wp_postmeta WHERE meta_key = 12345;
-- 这条走索引
SELECT * FROM wp_postmeta WHERE meta_key = '12345';

-- 索引列套函数,同样失效
SELECT * FROM wp_orders WHERE DATE(created_at) = '2026-10-24';
-- 改成范围查询,走索引
SELECT * FROM wp_orders WHERE created_at >= '2026-10-24' AND created_at < '2026-10-25';
这个坑没有报错、没有警告,只有 EXPLAIN 里一个安静的 ALL。排查「索引存在却不走」时第一个查它。
补充一个当天的后续:主题模板里还有一条 WHERE post_id IN (...) 的长列表查询,IN 的元素来自上游函数返回,偶发传入单个数字而不是数组,同样触发隐式转换。这类 bug 在开发环境数据量小,EXPLAIN 的 rows 差异看不出来,一到线上数据量上来就现形。给团队的约定是:比较值一律加引号、类型转换在应用层做,数据库层不做隐式魔法。
兜底预案:如果慢日志当时是关的呢
结论:没有慢日志时,三张表兜底——SHOW PROCESSLIST 抓现场、performance_schema 的 events_statements_summary 拉历史、sys.schema_table_statistics 找该加索引的表。
这次排查顺利是因为慢查询日志早就开着。换一台没开的机器,顺序改成:先 SHOW FULL PROCESSLIST 抓正在跑的(运气好能当场逮住 3 秒的查询),逮不住就走历史汇总:
-- performance_schema 里按总耗时排前 5 的语句,默认开着(MySQL 8.0)
SELECT DIGEST_TEXT, COUNT_STAR, SUM_TIMER_WAIT/1e12 AS total_s
FROM performance_schema.events_statements_summary_by_digest
ORDER BY SUM_TIMER_WAIT DESC LIMIT 5;
SUM_TIMER_WAIT 除以 1e12 换算成秒,COUNT_STAR 是执行次数——两个数字相乘才是这台机器真正的痛点,和 mysqldumpslow 按「总耗时」排序是同一个思想。兜底三板斧不如慢日志顺手,但足够在没有任何准备的情况下把「哪条 SQL 最该死」定下来;开日志这件事,永远别等出事再做。
常见问题
Q:开慢查询日志影响性能吗?
A:阈值 1 秒以上时开销可忽略,只记录本来就慢的查询。0.1 秒以下的高频记录在大流量站才有感知。
Q:加索引会锁表吗,线上怎么操作?
A:InnoDB 8.0 默认在线加索引(ALGORITHM=INPLACE),业务不中断但会有短暂的元数据锁,21 万行实测 1.8 秒。千万行大表用 pt-online-schema-change。
Q:mysqldumpslow 和 pt-query-digest 用哪个?
A:mysqldumpslow 随 MySQL 自带,够用;pt-query-digest 的维度更全(按总耗时、按次数、按锁时间多维排序),查询量大后值得装。
Q:索引加了为什么第二天又慢了?
A:查统计信息是否过期(ANALYZE TABLE 刷新)、是否有新查询模式没被现有索引覆盖、是否有锁等待被误判为查询慢。慢查询不是修一次就终身的病,日志和监控要长期留着。
Q:复合索引的字段顺序怎么定?
A:按「等值条件在前、范围条件在后、排序列跟在范围后面」排。这次如果要加的是 (meta_key, meta_value) 复合索引,meta_key 等值放最左才有效,顺序颠倒了索引就用不上,等于白建。建之前把最常用的那条查询拿出来对着排。
如果慢的是写不是读,还按这套流程吗?
结论:思路一样,但证据换地方——写的瓶颈不看 EXPLAIN,看 InnoDB 的锁等待和刷盘压力。
那次晚上那次二次变慢就是写侧问题:SHOW ENGINE INNODB STATUS 的锁段里两条 UPDATE 互相等行锁,SHOW PROCESSLIST 里大量 Lock wait。读慢看执行计划,写慢看锁和磁盘:sys.innodb_lock_waits 找出互相等的两条语句,SHOW GLOBAL STATUS LIKE 'Innodb_row_lock%' 看累计等待。上一次深夜排查 OOM 的经验在这里同样适用——先确认哪一类资源到顶了,再动手改,别把读优化的药方硬套给写问题。