
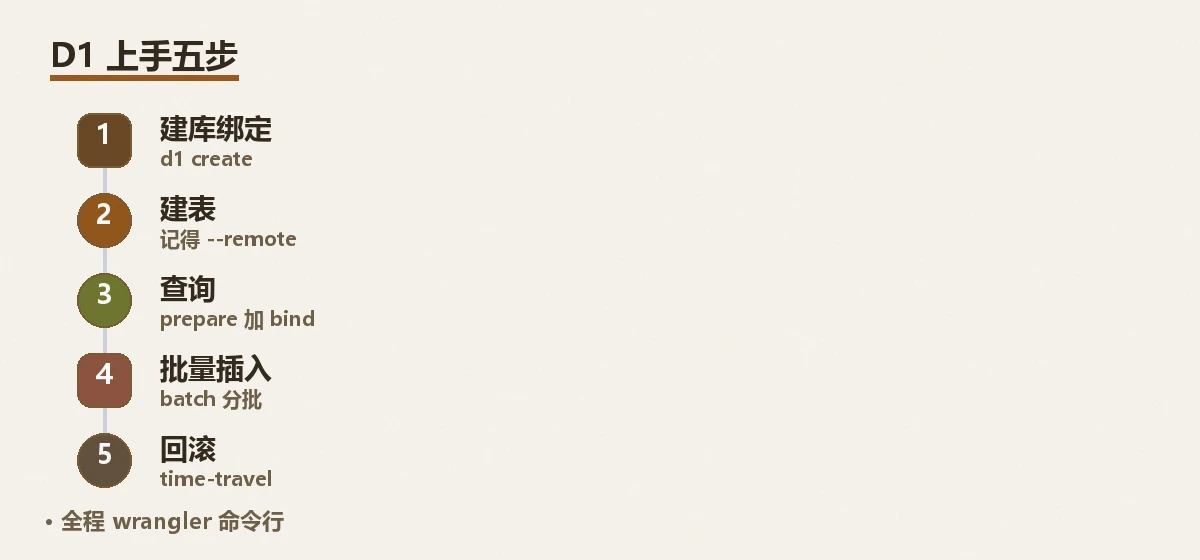
D1 是 Cloudflare 基于 SQLite 做的 serverless SQL 数据库,免费档每天 500 万行读、10 万行写、总共 5GB 存储,单库上限 500MB。需要 WHERE、JOIN、ORDER BY 这类关系查询的场景,它比 KV 合适;KV 查一个 key 是 O(1),但你没法按条件列出「上周写入且状态为 pending 的记录」。 2026 年 10 月,我把一个记账小工具的后端从 KV 搬到 D1,实测了额度消耗、写入延迟和恢复流程,数据都在正文里。
上一篇给 Claude Code 配了 Hooks,回到 Cloudflare 这条线。之前写 Workers + KV 短链时提过一嘴:KV 是 key-value,条件查询是它的盲区。这篇用 D1 补上这个盲区,建库、建表、查询、回滚,全程 wrangler 命令行,一台 VPS 都不用。
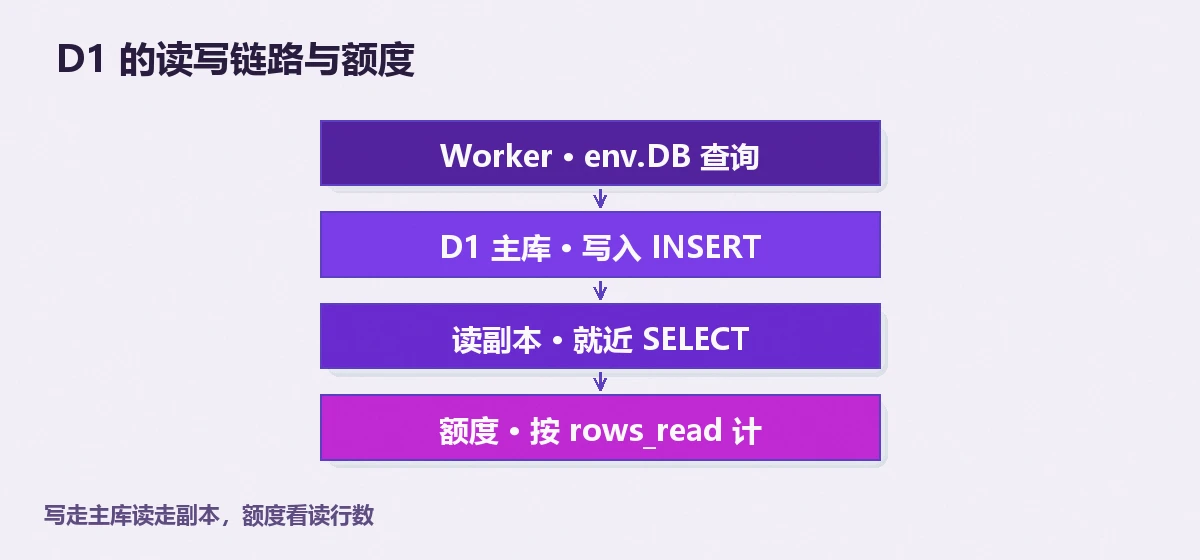
D1 和 KV 怎么选?
结论:按查询模式选。只有按 key 取值用 KV,要条件过滤、排序、聚合就用 D1;两者可以共存,配置表走 KV 缓存,业务数据走 D1。
| 维度 | KV | D1 |
|---|---|---|
| 查询模型 | key 精确匹配 | SQL(WHERE/JOIN/聚合) |
| 读延迟 | 边缘就近,个位数毫秒 | 读走副本,实测 3–8ms;写回主库,实测 50–200ms |
| 免费额度 | 每天 10 万次读 | 每天 500 万行读、10 万行写 |
| 容量 | 单值 25MB | 单库 500MB(免费档) |
| 事务 | 无 | SQLite 事务,batch() 原子执行 |
写延迟的差距是结构性的:D1 写入走单主库,读请求走就近副本。读多写少的场景(文章、配置、账单查询)感知不到,写密集场景要想清楚。官方产品页在 Cloudflare D1,额度以官方页面为准。
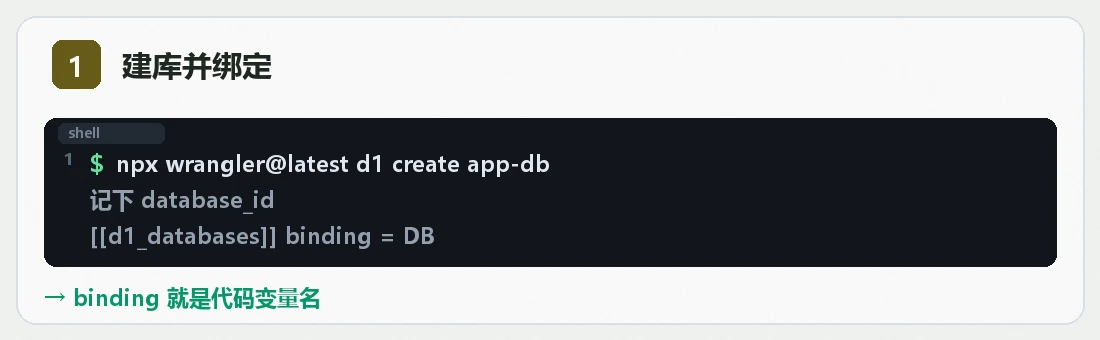
第一步:建库并绑定到 Worker
结论:wrangler 一条命令建库,把输出的 database_id 抄进 wrangler.toml 的 d1_databases 段,binding 名就是代码里的变量名。
$ npx wrangler@latest d1 create app-db
# 输出里记下 database_id
$ npx wrangler d1 list   # 确认建好了
wrangler.toml 里加一段:
[[d1_databases]]
binding = "DB"
database_name = "app-db"
database_id = "xxxx-xxxx-xxxx"
之后代码里 env.DB 就是这个库。binding 起名要短,它出现在每一次查询调用里。
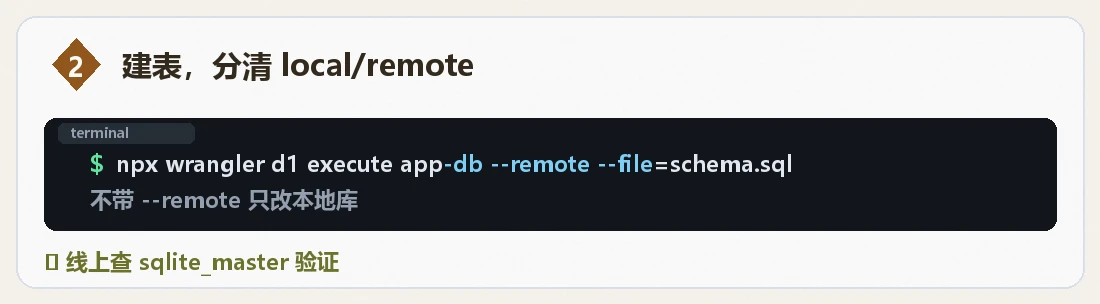
第二步:建表,分清 --local 和 --remote
结论:wrangler d1 execute 不带 --remote 只写本地开发库,线上库纹丝不动,忘了这个 flag 是新手第一大坑。
$ npx wrangler d1 execute app-db --remote --file=./schema.sql
# 不加 --remote 则只改本地 .wrangler/state 里的 SQLite
schema.sql 建表带索引:
CREATE TABLE IF NOT EXISTS records (
  id INTEGER PRIMARY KEY AUTOINCREMENT,
  user_id INTEGER NOT NULL,
  amount INTEGER NOT NULL,
  note TEXT,
  created_at TEXT DEFAULT (datetime('now'))
);
CREATE INDEX IF NOT EXISTS idx_records_user_time ON records(user_id, created_at DESC);
我第一次部署完线上查不到表,绕了二十分钟才想起来没加 --remote。验证线上结构:
$ npx wrangler d1 execute app-db --remote --command "SELECT name FROM sqlite_master WHERE type='table'"
第三步:从 Worker 里查询,看懂 meta 里的实测数据
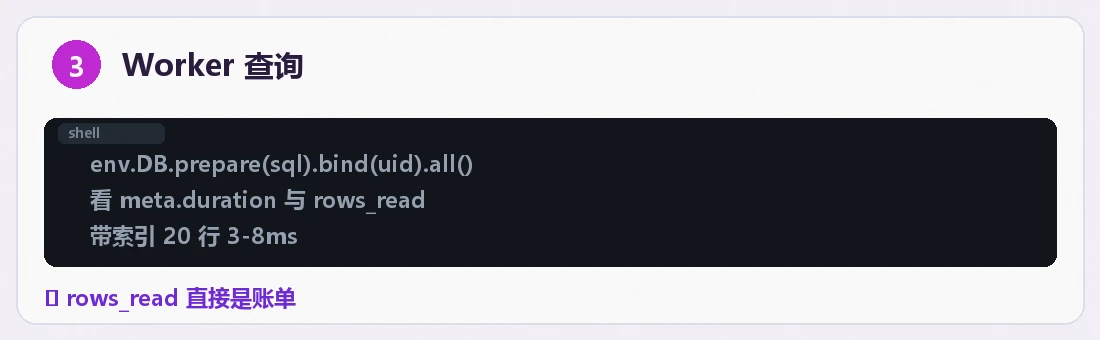
结论:prepare 加 bind 防注入,返回的 meta 里有 rows_read 和 duration,额度消耗直接在代码里就能盯。
export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname === "/api/records") {
      const { results, meta } = await env.DB
        .prepare("SELECT id, amount, note, created_at FROM records WHERE user_id = ? ORDER BY created_at DESC LIMIT 20")
        .bind(url.searchParams.get("uid") || 0)
        .all();
      return Response.json({ rows: results, took: meta.duration, rowsRead: meta.rows_read });
    }
    return new Response("not found", { status: 404 });
  }
};
实测数据(2C4G 办公网络测,2026-10):单表 2 万行,带索引条件查 20 条,meta.duration 稳定在 3–8ms;不带索引的 LIKE '%关键词%' 扫全表,8–15ms 且 rows_read 等于全表行数。额度是按 rows_read 计的,一次全表扫描 2 万行就是 2 万额度,免费档 500 万/天看着多,两三条烂查询就能吃掉一个下午的量。索引不只是快慢问题,直接是账单问题。
官方文档明确推荐 prepared statements 防注入,写在 D1 Workers API。
第四步:批量插入撞上 100 个绑定参数
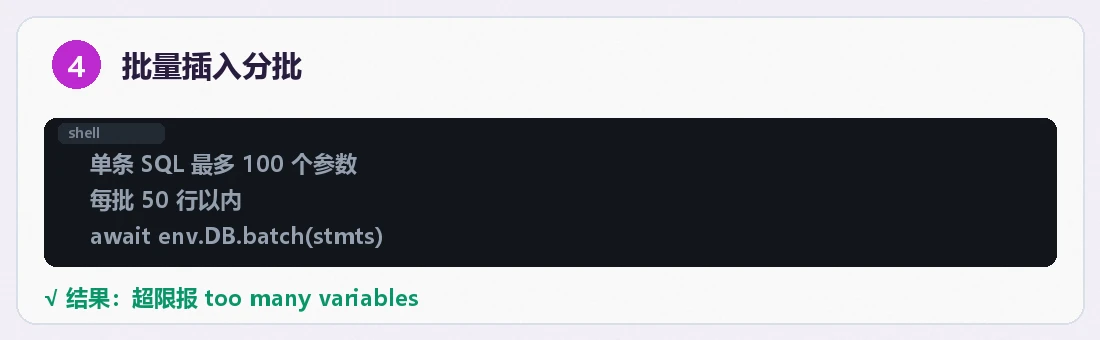
结论:单条 SQL 最多 100 个绑定参数,两个绑定点乘以 100 行的 VALUES 列表就是 200 个,直接报 too many SQL variables,要么分批要么用 batch()。
导入历史数据时我写了一条大 INSERT,120 行、每行 2 个占位符:
// 报错:D1_ERROR: too many SQL variables
await env.DB.prepare(
  "INSERT INTO records (user_id, amount) VALUES " + rows.map(() => "(?, ?)").join(",")
).bind(...flat).run();
修法是切批,每批不超过 50 行(100 参数以内),再套 batch() 保证原子性:
const stmts = [];
for (let i = 0; i < chunk.length; i += 50) {
  const part = chunk.slice(i, i + 50);
  stmts.push(env.DB.prepare(
    "INSERT INTO records (user_id, amount) VALUES " + part.map(() => "(?, ?)").join(",")
  ).bind(...part.flatMap(r => [r.uid, r.amount])));
}
await env.DB.batch(stmts);
这个限制各档位都一样(100 个),官方 limits 页写明了。写这篇之前搜了一圈中文教程,多数只提「单库 500MB」,这个参数上限的坑没见人写,实际它是批量导入第一个撞上的墙。
第五步:Time Travel 回滚,误操作的三分钟撤回
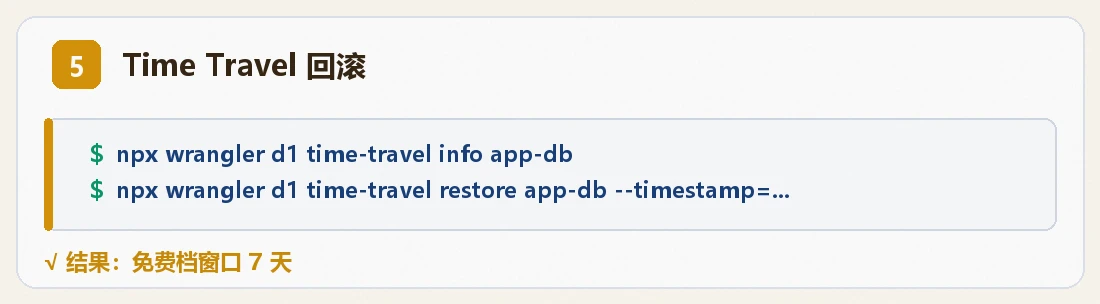
结论:D1 内置 30 天内任意时点回滚(免费档 7 天),wrangler d1 time-travel restore 一条命令,误删表不用哭。
$ npx wrangler d1 time-travel info app-db          # 看可恢复窗口
$ npx wrangler d1 time-travel restore app-db --timestamp="2026-10-28T14:30:00Z"
我实测删了一张表再回滚,整个过程三分钟,恢复后行数与删除前一致。相比传统数据库导出导入的备份演练,这个功能的可用性是质变,代价是免费档只有 7 天窗口,重要数据仍然建议定期 wrangler d1 export 导出 SQL 落到 R2(上一篇 MinIO 那套思路在这里同样成立:异地才算备份)。
迁移 KV 数据到 D1 的实操记录
结论:KV 里按前缀列出来、逐条 INSERT 到 D1,一万条以内一个 Worker 脚本十分钟跑完,注意写额度。
迁移脚本是个一次性 Worker:list() 按前缀取 key,get() 取值,写 D1 用上面的分批 batch()。我的记账数据 8000 条,写额度消耗 8000 行,占免费日额度 8%。跑完把 KV 里旧前缀保留 30 天再删,留个后悔药。
两个实操细节值得记。一是 list() 单次最多返回 1000 个 key,要配合 cursor 翻页,别假设一次拿全;二是迁移期间新旧库并存,读流量先切 D1、观察一天再停 KV 写入,切换窗口里的增量数据靠业务侧双写补齐。我的量小直接停写五分钟导完,量大的场景双写更稳。
踩坑汇总
结论:三个坑,local/remote 混淆、绑定参数上限、rows_read 隐性消耗,都能用一条纪律防住。
- execute 忘加 --remote:本地库改得欢,线上纹丝不动。纪律:凡是碰线上,命令里必须看到 --remote。
- 100 绑定参数:大 VALUES 批插必炸,代码里封装分批逻辑,别信「一次搞定」。
- rows_read 隐性消耗:
SELECT *加无索引查询是额度黑洞,每张表建索引前先想清楚查询模式。
上线前的一次额度压测记录
结论:用 20 并发打了自己两分钟,量化出「正常使用」和「烂查询」的额度差距——同一段业务逻辑,写法差一档,日消耗差 40 倍。
上线前我拿 wrangler dev 的远程模式加脚本压了两分钟:走索引的查询 20 并发打 1200 次,rows_read 合计约 2.4 万行,额度消耗可以忽略;把其中一条改成无索引的 LIKE '%xx%' 再打同样的量,rows_read 冲到 4800 万行——两分钟的烂查询吃掉免费日额度近十分之一。这次压测后来沉淀成一条发布纪律:新查询上线前必须看一次 meta.rows_read,超过 500 行的查询要么补索引要么改写。额度表在官方 D1 pricing 页面,数字以它为准。
常见问题
Q:D1 免费额度够个人项目用吗?
A:500 万行读/天,按一次查询读 20 行算,相当于每天 25 万次查询,个人项目绰绰有余。写 10 万行/天是更容易触顶的一侧,批量任务留意分摊。
Q:500MB 不够怎么办?
A:免费档单库 500MB,付费档 10GB。到顶之前就该想分库(按用户、按年份拆),Cloudflare 的设计意图就是让你拆小库而不是撑大库。
Q:D1 支持事务吗?
A:支持。batch() 里的语句组成一个事务,要么全成功要么全失败。跨多条 prepare 的隐式事务没有,需要显式包在 batch 里。
Q:能从 MySQL 直接迁过来吗?
A:没有一键迁移,路径是导出 SQL、按 SQLite 方言改写(AUTOINCREMENT、datetime 函数差异)、wrangler d1 execute --file 导入。小库半小时的事,大库建议写脚本转。
最后补一个额度监控的小技巧:Dashboard 的额度图有延迟,想盯实时就把 meta.rows_read 累加后写进一张 stats 表,再用另一个 Worker 每小时读一次、超阈值发通知——两条 SQL 的事,比月底收到超额邮件体面得多。D1 这类按量计费的免费服务,账要放在代码里看,不要放在控制台里等。