
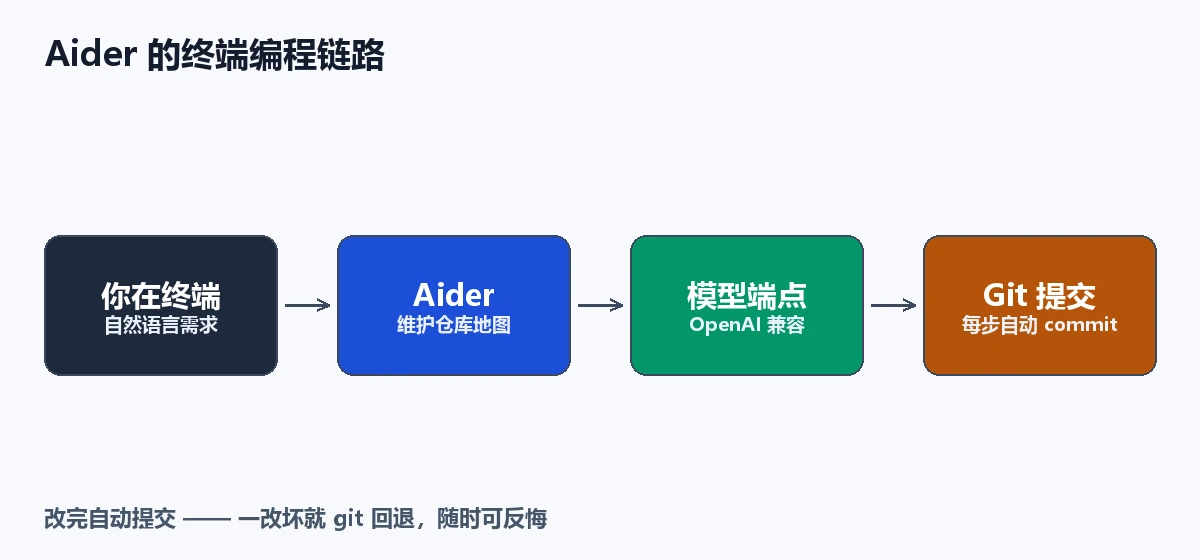
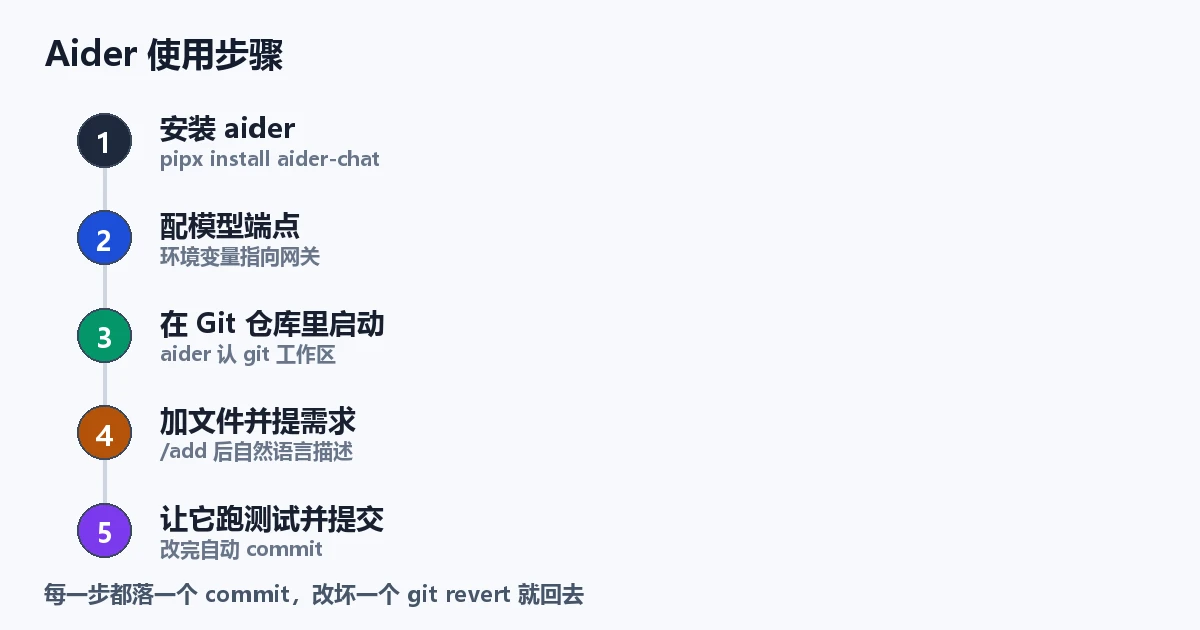
Aider 的定位是「终端里的结对程序员」:你在 Git 仓库里启动它,用 /add 把要改的文件加进上下文,然后用自然语言描述需求,它直接编辑文件、运行测试、并且每完成一步就自动 git commit——所以任何一次改动都能用 /undo 或 git revert 回退。 它对模型端点的要求很低:只要对方是 OpenAI 兼容接口,改几个环境变量就能把后端指向国产大模型网关。我在 2026 年 10 月用它改一个中等规模的 Python 项目,最大的感受是「自动提交」这个设计把 AI 编程的风险降到了最低——不怕它改错,只怕自己不敢试。
上面这段是结论块。下面是安装、接国产模型、工作流组织,以及两个真会踩的坑。
Aider 和 Claude Code / Codex CLI 差在哪?
结论:Aider 的优势是「模型无关 + 自动 git 提交 + 终端轻量」,弱点是上下文管理和工具调用不如专用 CLI 丰富。 三者的取舍:
| 维度 | Aider | Claude Code | Codex CLI |
|---|---|---|---|
| 后端模型 | 几乎任意(LiteLLM) | Anthropic 系为主 | OpenAI 系 / 兼容端点 |
| 自动提交 | 默认开启,核心特性 | 需手动/配置 | 需手动 |
| 上下文管理 | /add 显式加文件 + repo map |
自动探索 | 自动探索 |
| MCP 支持 | 有限 | 完善 | 有限 |
| 适合谁 | 想用国产模型省钱、喜欢掌控提交的人 | 重度依赖 Claude 生态 | 重度依赖 OpenAI 生态 |
如果你已经习惯 Claude Code,可以让它接国产模型(做法见 Claude Code BASE_URL 接入);Aider 的独特价值在于它对模型完全中立,且自动提交是默认行为——同一套操作,换后端模型不用改任何习惯。
Aider 五个步骤
第一步:安装 Aider
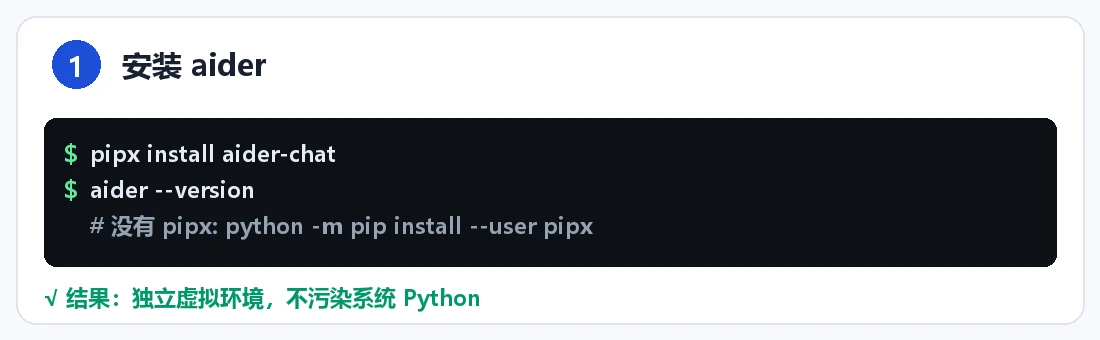
推荐用 pipx,装进独立的虚拟环境,不污染系统 Python:
$ pipx install aider-chat
$ aider --version
# 没有 pipx:python -m pip install --user pipx && python -m pipx ensurepath
也可以用官方 install 脚本:python -m pip install aider-install && aider-install。
第二步:把模型端点指向国产网关
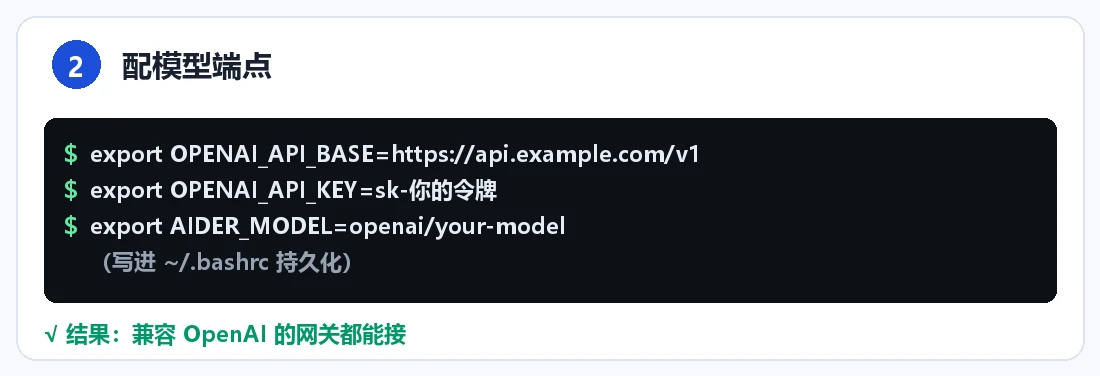
Aider 靠 LiteLLM 调度模型,接 OpenAI 兼容端点用环境变量:
$ export OPENAI_API_BASE=https://api.example.com/v1
$ export OPENAI_API_KEY=sk-你的令牌
$ export AIDER_MODEL=openai/your-model-name
注意 AIDER_MODEL 里的 openai/ 前缀是要保留的——它告诉 Aider 走 OpenAI 兼容协议,后面的模型名由你的网关路由。如果网关是 new-api 这类聚合接口,一个端点后面挂着多家模型,换模型时只改模型名。
把这些写进 ~/.bashrc(或项目里的 ~/.aider.conf.yml)持久化。
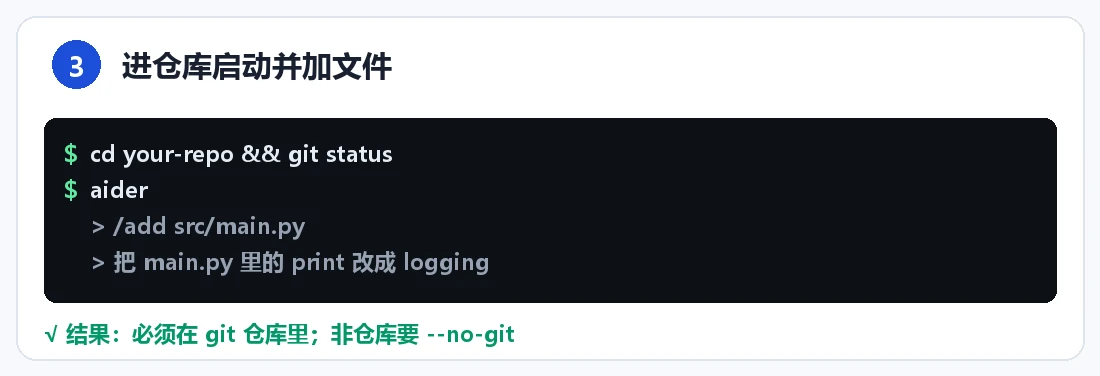
第三步:在 Git 仓库里启动
$ cd your-repo
$ git status          # 确认工作区干净,便于观察 aider 的改动
$ aider
Aider 的核心前提是「工作区是一个 Git 仓库」——它靠 git 来做提交和撤销。没有 git 的目录启动会直接报错退出。
启动后先加载文件:
> /add src/main.py src/utils.py
/add 是显式加文件,Aider 会把它们纳入上下文。不要一次性 /add 上百个文件——那是超 token 的头号原因。
第四步:描述需求并迭代
> 把 main.py 里的 print 调试输出改成 logging,级别可配置
> /run python -c "import main"
Aider 会给出 diff,然后自动提交。看它的改动是否符合预期,不符就 /undo。
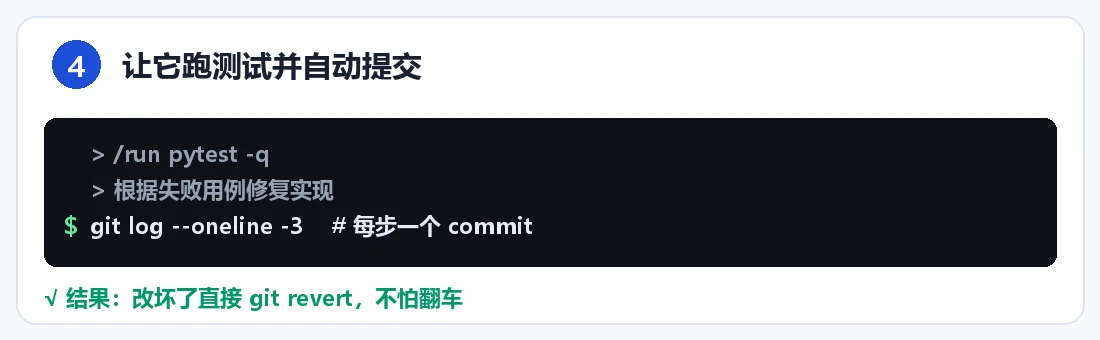
/run 让它执行命令,输出回到上下文里,所以你可以让它「跑测试、看失败、修代码、再跑」,形成闭环:
> /run pytest -q
> 根据失败用例修复实现,不要修改测试
第五步:用 git 兜住所有改动
$ git log --oneline -3
# a1b2c3d aider: 改 print 为 logging
# 9f8e7d6 aider: 修复 test_utils 失败
每一次 Aider 的改动都是一个独立 commit,历史清晰可追。改坏了:
$ git revert <commit> # 或会话里 /undo
这是 Aider 最让人放心的地方——用 AI 改代码最大的心理障碍是「改坏了怎么办」,自动提交直接把这个障碍拿掉了。
两个真会踩的坑
-
上下文范围失控 → 超 token 或改错文件。 Aider 的 repo map 会扫描整个仓库,如果仓库里有
node_modules、大日志、dist等目录,它会把这些也纳入索引,既拖慢又浪费 token。加一个.aiderignore文件(语法同.gitignore)排除它们,是启动前的必做动作。同时,/add的文件越少越好——只加和当前任务相关的。 -
自动提交会把你的中间改动也一起提交。 如果你在 Aider 会话中途手动改了别的文件,下一次 Aider 提交可能把两者混在一起。习惯是:开 Aider 前先
git status确认干净;需要手动改时就先退出 Aider。 另外可以设--no-auto-commits关掉自动提交,改为自己控制节奏——但那样就失去了 Aider 最大的安全网,不推荐新手这么做。
一点使用心得
让 Aider 干活,条件要写死。 它的模型能力取决于你接的后端:接一个便宜的小模型,它能做的是«改命名、抽函数、写测试骨架»这类确定性任务;复杂重构还是得用更强的模型。我的做法是按任务分级换模型——简单改动用便宜模型,复杂逻辑切到强模型,同一套 Aider 习惯不变。
如果你的项目里有多个 AI 编程工具并存,注意它们对配置文件的写法不同:Codex CLI 用 config.toml 定义 provider、Claude Code 用环境变量、Aider 也有自己的 ~/.aider.conf.yml。别把三者的配置混在一处,各自独立更不容易错。
Aider 常见问题(2026)
Q:Aider 收费吗?
A:Aider 本身开源免费。花的钱是模型调用费——接国产模型的话通常比接国外模型便宜一个数量级。
Q:必须联网吗?
A:必须。Aider 本身不含模型,所有推理都在你配的端点(云端或你本地的模型服务)上完成。
Q:和 Cursor 这种 IDE 比,Aider 有什么优势?
A:Aider 是终端工具,不依赖编辑器界面,可以 SSH 到服务器上用,也更容易脚本化/自动化。喜欢图形界面、要内联补全的人更适合 Cursor 类工具。
Q:/undo 只能撤销最后一步吗?
A:/undo 撤销 Aider 最近一次提交;要回退多步用 git 本身(git reset / git revert)。因为每步都是独立 commit,回退粒度很细。
Q:怎么让它用本地模型?
A:把端点指向本机的推理服务(如 Ollama 的 OpenAI 兼容口),OPENAI_API_BASE=http://localhost:11434/v1 即可。模型能力够不够,取决于你本地跑的模型大小。
一句总结
Aider 把「AI 改代码」这件事变得可逆:自动提交是它的核心安全网,模型中立是它的核心自由。 装上、接上你常用的模型端点、/add 几个文件,剩下的就是在一次次自动 commit 里放心地试。