
服务器出事的时候,你往往不是第一个知道的
先说一个我自己遇到的场景。去年冬天有台机器内存被一个失控的脚本吃满,Linux 的 OOM killer 开始杀进程。Nginx 是最后被杀的,所以在那之前网站一直能访问。等我发现的时候,已经过去两个小时,中间重启了三次 MySQL。
探针要解决的就是这件事:把每台机器的 CPU、内存、硬盘、流量、在线状态收拢到一个面板上,异常了主动推给你。在宕机之前知道要宕机,比事后翻日志有用太多。
站上之前分别写过哪吒、Komari、Worker 探针各自怎么部署,但一直缺一篇回答最关键问题的东西:我到底该选哪个。这篇补上。
先分清两类东西,选错方向就白装了
很多人把「探针」和「网站监控」当成一回事,结果装完了才发现看不到想看的指标。
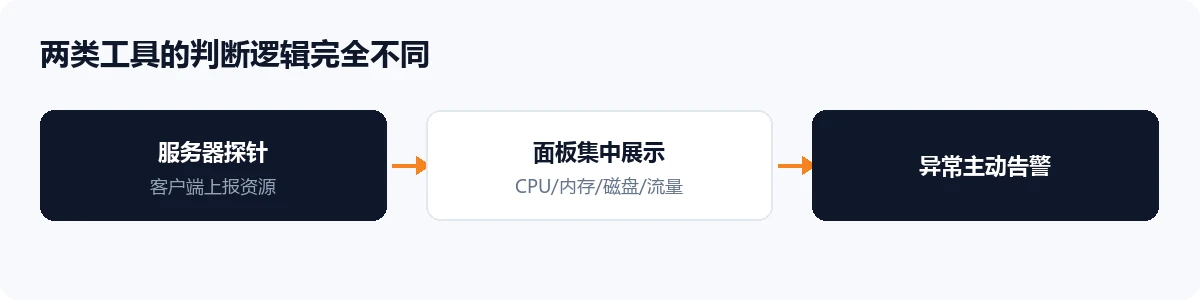
服务器探针:在被监控的机器上跑一个客户端,定期把资源数据上报给面板。看的是机器本身——CPU 负载、内存占用、磁盘剩余、网络速率。
状态监控:从外部去请求你的网站或者端口,看通不通。看的是服务可用性,被监控的机器上什么都不用装。
判断逻辑完全不同。我上面那个例子属于前者:服务还能访问,但机器快爆了,只有探针能看到。反过来,机器资源全空闲但 Nginx 进程挂了,只有状态监控能发现。
成熟的做法是两套都上。我现在就是这样:哪吒看资源,Uptime-Kuma 看服务。
四款主流方案放一起看
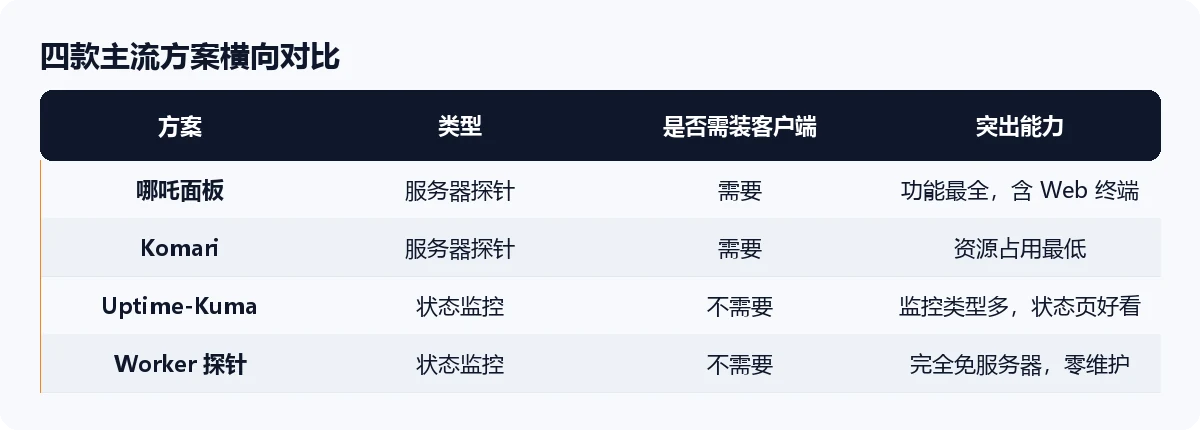
下面逐个说适合谁。
哪吒面板
Go 写的自助监控面板,功能最全。资源监控、在线状态、告警推送之外,还带 Web 终端(浏览器里直接连 SSH)、文件管理、定时任务、DDNS。
架构是服务端 + 客户端:服务端部署在你某台机器上,客户端装到每一台被监控的机器上。
适合机器数量多(三台以上)、需要集中管理和远程操作的人。功能最全的代价是配置项也最多,我第一次配通知渠道搞了快一个小时。
Komari
比较新的开源面板,主打资源占用低。
哪吒的服务端本身也要吃一些资源,Komari 的定位就是把这块压到最小,适合跑在小内存机器上。如果你手头都是 1G 内存的小鸡,Komari 比哪吒更合适。
适合只有一两台机器、对资源占用敏感、够用就行的场景。
Uptime-Kuma
严格说它是状态监控,不是服务器探针,别指望它告诉你 CPU 用了多少。
强项是监控类型丰富:HTTP、TCP、Ping、DNS、关键词检测、证书到期提醒,而且自带一个挺好看的状态页,可以对外公开服务可用性。我给这个站挂了个公开状态页,读者能看到服务是不是在线。
适合个人服务、想对外展示可用性、需要证书到期提醒的人。
Cloudflare Worker 探针
完全不需要服务器,跑在 Cloudflare Workers 上,零成本零维护。
它解决的是「你已经有机器了,不想为了监控再单独养一台」这个问题。
限制也很清楚:Workers 只能做 HTTP 层的探测,拿不到任何服务器内部数据。免费额度的请求数也有上限,监控项不能开太多、频率不能拉太高。
适合纯静态站、只有几个域名要盯、完全不想碰服务器的场景。
三个问题定方案
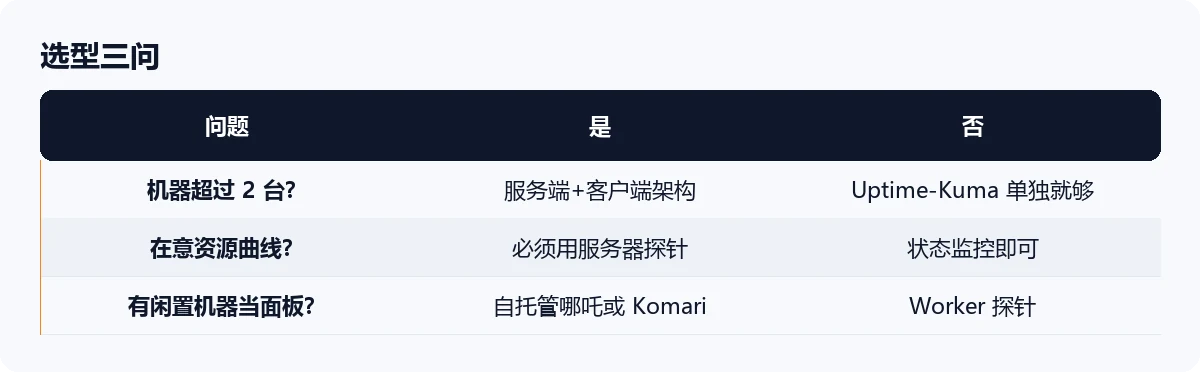
机器超过 2 台吗? 是的话走服务端 + 客户端架构(哪吒或 Komari);不是就用 Uptime-Kuma 单独盯着,装探针的收益不大。
在意资源曲线吗? 想看 CPU、内存、硬盘、流量的历史走势,只能用服务器探针。只关心服务通不通,Uptime-Kuma 或 Worker 探针就够。
有闲置机器能当面板吗? 有就自托管哪吒或 Komari;一台都没有就走 Worker 探针,或者把面板丢到免费容器上跑。
💡 面板如果和被监控的机器是同一台,机器挂了面板也挂,告警就失去意义了。理想情况下面板要放在独立的机器上。
这条我自己踩过。早期图省事,面板和被监控的机器都在同一台小鸡上,那次机器死机,我什么告警都没收到。
以哪吒为例的部署要点
把哪吒的配置逻辑搞懂,其他几个都是照葫芦画瓢。
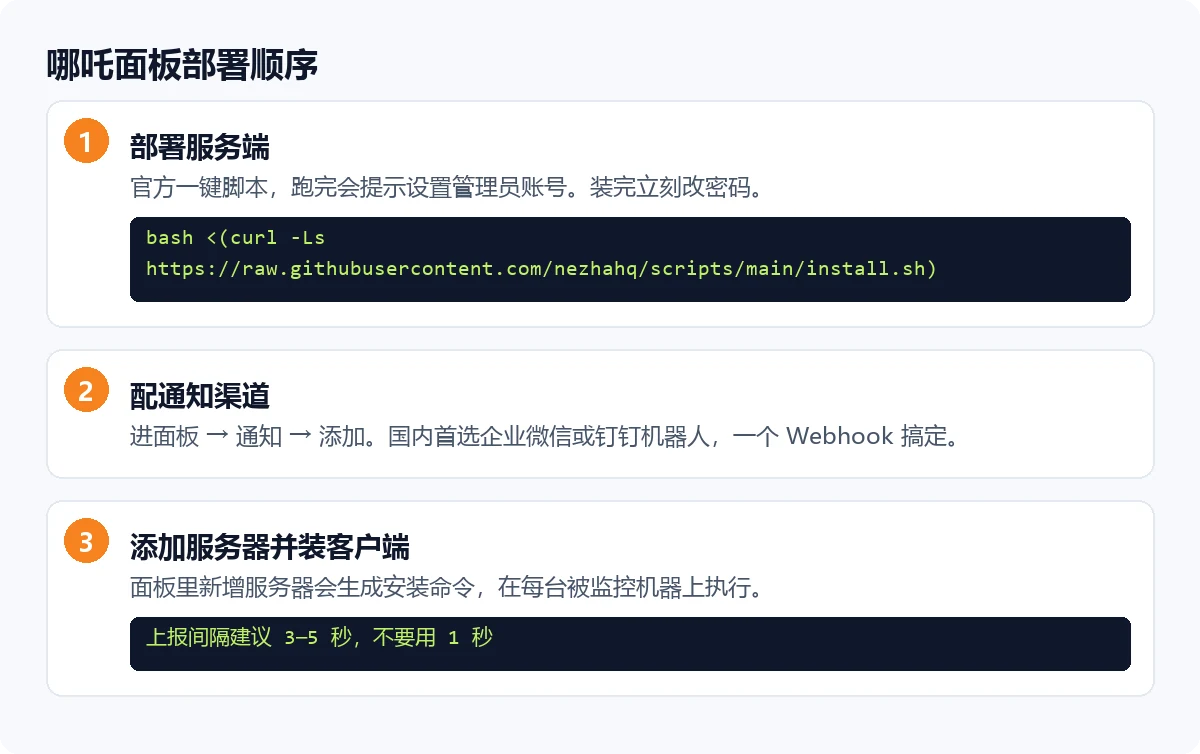
服务端
官方有一键脚本,跑完会提示你注册管理员账号。
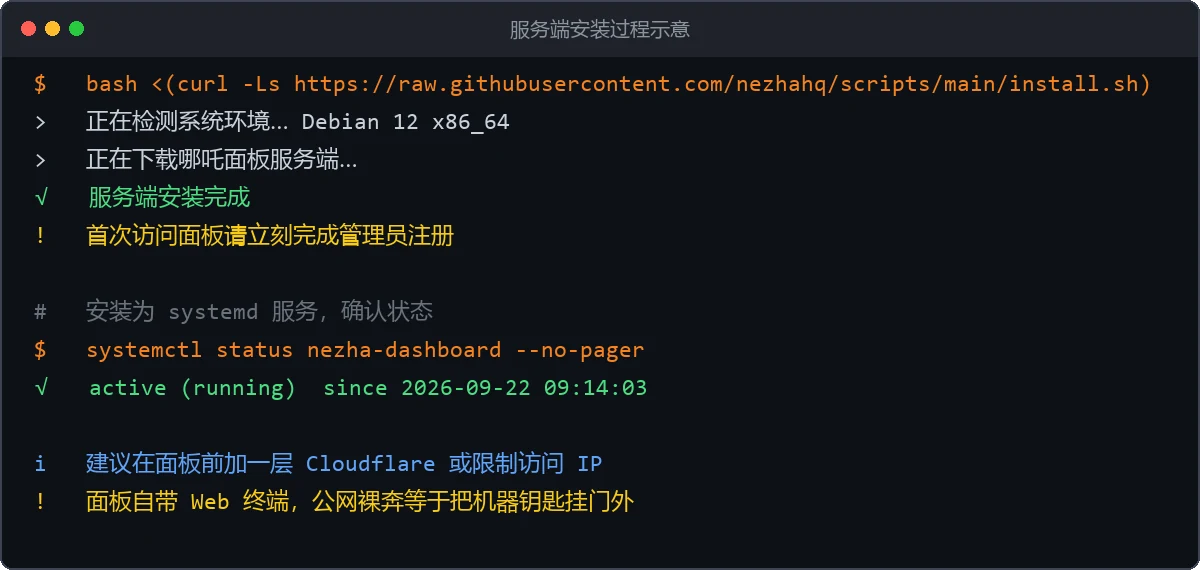
装完登录进去,先把这三件事做掉:
- 改管理员密码(脚本会强制,别跳过)
- 设置站点名称和主题(默认外观挺朴素的)
- 配通知渠道,下一节细说
客户端
在面板里添加服务器,会生成一段安装命令,在每台被监控的机器上执行。
几个关键点:
- 客户端要装成 systemd 服务,否则重启机器就断了上报
- 上报间隔别设太短。默认 1 秒一次对面板和网络都是负担,3 到 5 秒足够
- 机器在 NAT 后面也没关系,客户端是主动连面板的,不需要公网 IP
告警渠道:别只挂一个邮件
探针的价值一半在监控,一半在告警。告警配得不到位,等于白装。
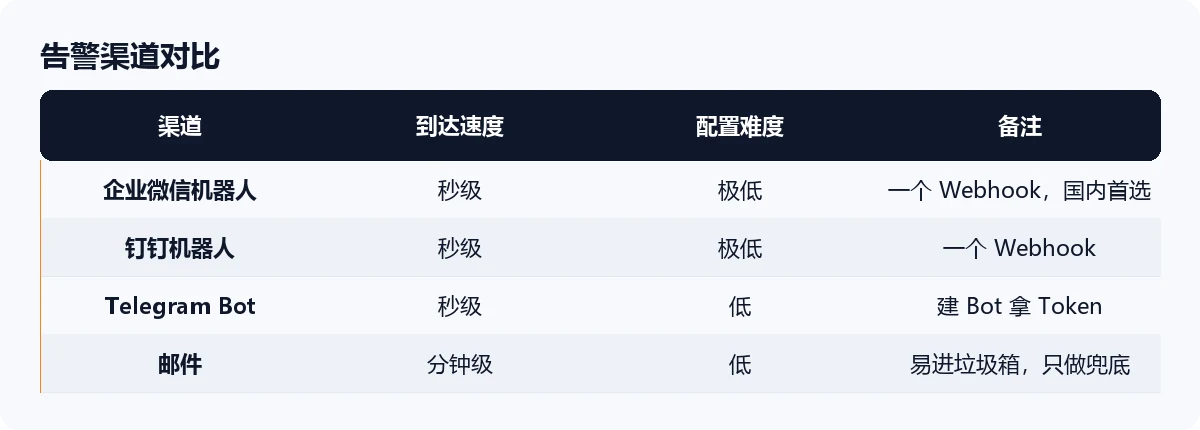
| 渠道 | 到达速度 | 稳定性 | 配置难度 |
|---|---|---|---|
| Telegram Bot | 秒级 | 高 | 低,建 Bot 拿 Token |
| 企业微信机器人 | 秒级 | 高 | 极低,一个 Webhook |
| 钉钉机器人 | 秒级 | 高 | 极低,一个 Webhook |
| 邮件 | 分钟级 | 中,容易进垃圾箱 | 低 |
| 自定义 Webhook | 秒级 | 取决于你的服务 | 中 |
我现在的组合是企业微信机器人 + Telegram 双通道,邮件只当兜底。之前只用邮件吃过亏:机器凌晨两点挂了,通知进了垃圾箱,早上八点才看到。
国内用户首选企业微信机器人。建个群,加一个群机器人,把 Webhook 地址填进探针配置,一分钟的事。
五个我实际踩过的坑
上报间隔设太短,把面板自己打挂
一台机器 1 秒上报一次,十台就是每秒十个请求。面板如果跑在小机器上,内存会一路往上涨。3 到 5 秒是合理区间。
磁盘和流量告警没开
大多数人只配了 CPU 和内存告警。实际上磁盘写满导致服务挂掉是最常见的宕机原因,而且完全可预防。磁盘使用率到 80% 就该告警。
面板自己挂了没人知道
面板服务器需要另一套系统从外面看着。最省事的做法是用免费的 Worker 探针去监控面板地址,两套系统互相盯着。
告警风暴,最后你开始无视通知
一次网络抖动能触发几十条告警。几次之后你就对通知脱敏了,真有故障也懒得看。要配告警抑制:同一监控项在 N 分钟内只发一次,恢复的时候单独发一条恢复通知。
面板暴露在公网还用弱密码
面板带 Web 终端,等于把机器钥匙挂在门外。必须做的三件事:强密码、开两步验证(支持的方案就开)、限制访问 IP 或者用 Cloudflare Access 加一层。
我会怎么选
机器 2 台以内:Uptime-Kuma 一个就够,把 HTTP 监控和证书提醒配好,装探针性价比不高。
机器 3 到 10 台:哪吒面板 + 企业微信机器人告警。功能全、社区活跃、文档齐,出了问题好搜。
机器 10 台以上,或者对资源特别敏感:Komari,或者哪吒精简配置。注意面板和客户端要分开部署。
完全不想维护服务器:Worker 探针 + Cloudflare 的可用性通知。只能做 HTTP 层,但零成本零维护。
最后一句提醒:探针配好之后,请真的去测一次告警。手动把某个服务的端口关掉,看通知能不能在三分钟内到你手机。没测过的告警系统,和没装是一样的。
如果你还没有合适的机器来放面板,claw 免费容器完全指南 里讲了怎么用免费额度跑一个 Uptime-Kuma,零成本。机器本身想再压一压性能的话,Cloudflare Cache Rules 实战 那篇是从边缘层下手的。