
「我有备份」和「我能恢复」是两回事。放在同一台机器上的备份不叫备份——磁盘挂了、勒索加密了,两个一起没。我见过最典型的事故:快照策略配得好好的,全在同一块盘上,一次误操作连快照一起删。
真正靠谱的最低配置是:源机器 →(SSH)→ 另一台机器,每晚自动跑一次,保留多个历史版本。
结论前置:rsync 负责传、--link-dest 负责省空间、cron 负责无人值守、恢复演练负责让你相信它真的能用。
数据流向
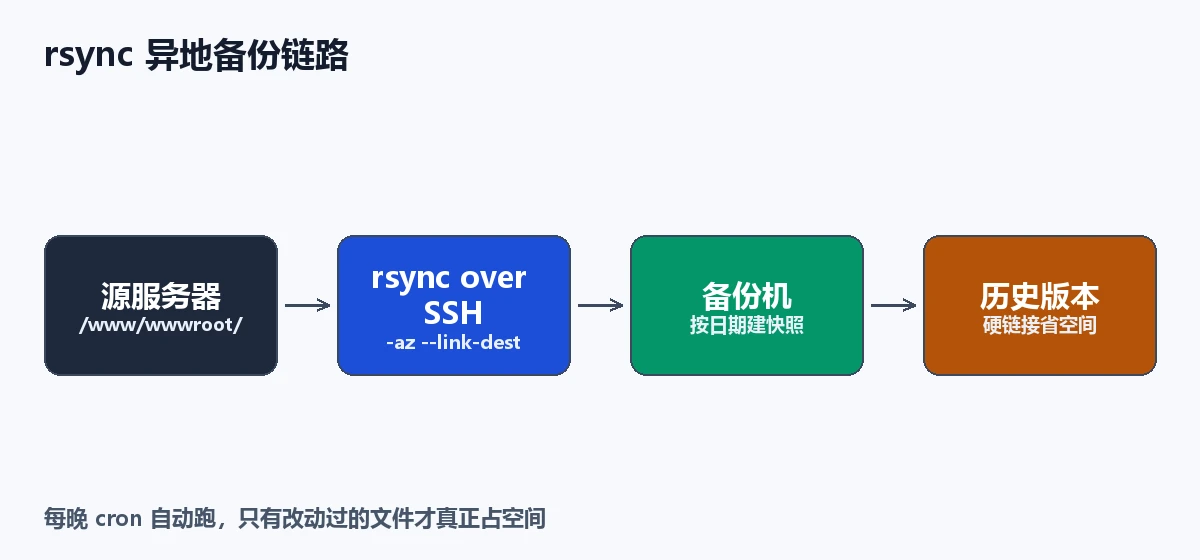
源服务器 → rsync over SSH → 备份机 → 按日期建快照目录(2026-09-20/、2026-09-21/……)。全程无人值守,靠 cron 触发。
操作步骤速览
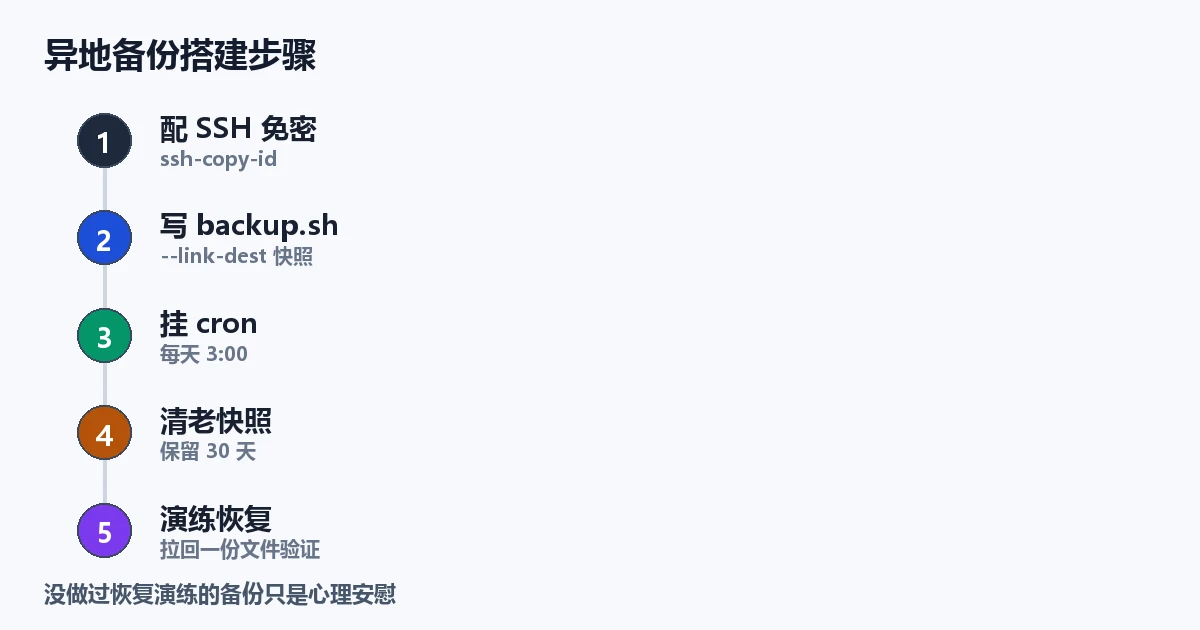
一、先做 SSH 免密
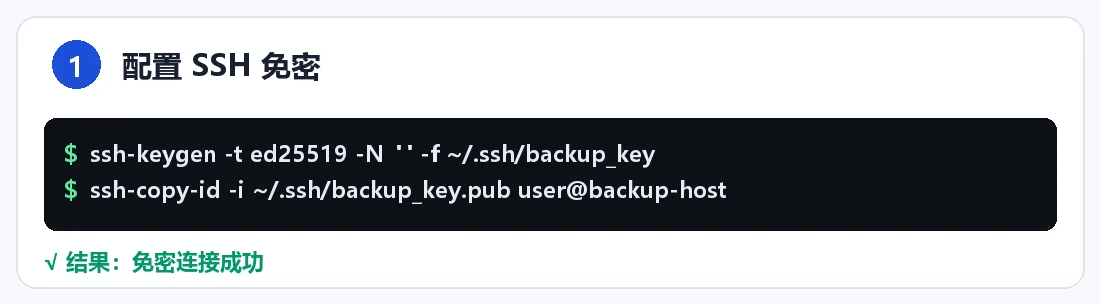
ssh-keygen -t ed25519 -N "" -f ~/.ssh/backup_key
ssh-copy-id -i ~/.ssh/backup_key.pub user@backup-host
免密是前提——cron 任务没法交互输密码。更进一步,可以在这把 key 上限制它能干的事(只允许 rsync,禁用 shell),万一泄漏也掀不起浪:
# 备份机 ~/.ssh/authorized_keys 行首加:
command="rsync --server --daemon .",no-pty,no-port-forwarding ssh-ed25519 AAAA... backup
二、核心命令:--link-dest 快照
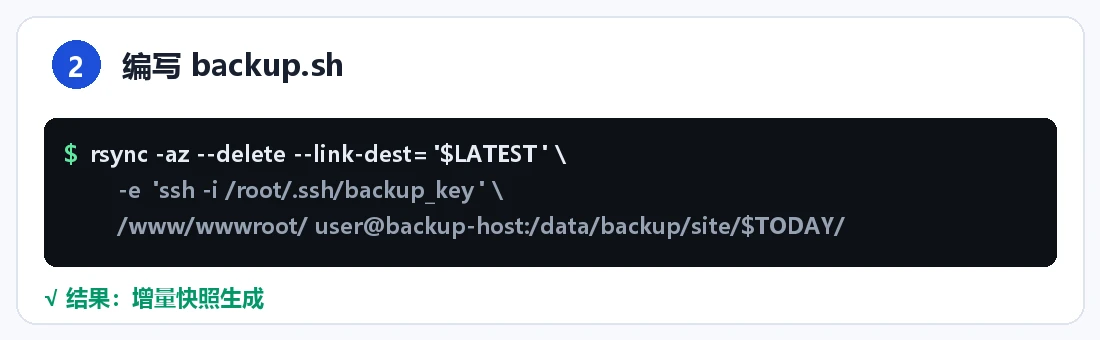
这套的精髓在 --link-dest:没变的文件用硬链接指向上一次快照,只有改动过的才真正占新空间。所以你能保留 30 天历史,占用却接近一份——因为相同内容在全盘只有一份实体数据,多个目录名共享同一个 inode。
#!/bin/bash
set -euo pipefail

SRC=/www/wwwroot/
HOST=user@backup-host
BASE=/data/backup/site
TODAY=$(date +%F)

# 上一次快照(拿最新的一个),首次运行可能为空
LATEST=$(ssh "$HOST" "ls -1d $BASE/*/ 2>/dev/null | sort | tail -1 || true")

if [ -n "$LATEST" ]; then
  LINK="--link-dest=$LATEST"
else
  LINK=""
fi

rsync -az --delete \
  $LINK \
  --partial \
  --exclude='*.log' \
  --exclude='cache/' \
  -e "ssh -i /root/.ssh/backup_key -o StrictHostKeyChecking=accept-new" \
  "$SRC" "$HOST:$BASE/$TODAY/"
逐项拆开:
-a保留权限、所有者、时间戳;-z传输压缩--delete让备份和源保持一致(这句有风险,见坑 ①)--partial断线可续,大文件不用从头再来--link-dest指向上一次快照,实现增量与省空间--exclude排掉日志和缓存,这类文件变了也不值得留
存成 /root/backup.sh,chmod +x /root/backup.sh。
三、挂 cron,每晚 3 点跑
crontab -e
# 加一行:
0 3 * * * /root/backup.sh >> /var/log/backup.log 2>&1
日志一定要重定向,不然出错了你永远不知道。选凌晨 3 点是为了错开业务高峰,也给白天的排查留时间。
光有日志还不够——没人会天天翻日志。给任务加一个心跳上报,超时就报警:在脚本末尾 curl -fsS https://hc-ping.com/你的UUID,用 healthchecks.io(或 Uptime-Kuma 的 Push 监控)盯着,"没跑"这件事才会主动来找你。
四、保留策略与恢复演练
保留 30 天,老快照删掉(-mtime +30 = 修改时间超过 30 天的目录):
find /data/backup/site -maxdepth 1 -type d -mtime +30 -exec rm -rf {} \;
删除很重要——不设保留策略,备份盘半年就满。
最关键的一步是演练恢复——随便挑一天,把一份文件拉回来,确认能打开:
rsync -av user@backup-host:/data/backup/site/2026-09-20/www/ ./restore-test/
没做过恢复演练的备份,只是心理安慰。
五个常见的坑
--delete把备份也清空了:源目录若被清空或路径写错(比如漏了结尾斜杠导致同步层级错位),会原样同步到备份。稳妥做法是给备份机的authorized_keys用command=锁死路径,源端再留一份本地快照兜底。- 断线重传整份:没加
--partial,网络抖一下大文件从头再来。 - 带宽被吃满:白天跑大备份会拖慢业务,加
--bwlimit=8000(KB/s)限速,或固定到凌晨。 - 拿同机快照当异地备份:路径不同≠介质不同。备份必须落在另一台物理机器或另一个存储。
- 只备份数据不备份配置:数据库文件在线拷贝可能不一致;MySQL/Redis 先
dump再同步,别直接 rsync 热数据文件。
五、到底该备份哪些东西
备份最怕两件事:漏了关键的、备了一堆垃圾。我按重要性排了个清单,照着核对一遍:
| 优先级 | 内容 | 说明 |
|---|---|---|
| ★★★ | 数据库导出的 dump | 热文件不能直接 rsync,先 mysqldump / pg_dump |
| ★★★ | 站点程序与上传目录 | /www/wwwroot/、wp-content/uploads/ |
| ★★★ | 各类服务的配置 | /etc/nginx、/etc/ssh、Docker compose.yml |
| ★★☆ | 证书与密钥 | /etc/letsencrypt、SSH 私钥(单独加密保存) |
| ★★☆ | 定时任务与脚本 | crontab -l、/root/*.sh |
| ★☆☆ | 日志与缓存 | 不备份,排掉省空间 |
一条容易踩的坑:数据库别直接 rsync 数据文件。MySQL 运行中数据文件与内存状态不一致,拷出来的可能无法恢复。正确姿势是先落地一份逻辑导出再同步:
# 备份机上定时拉取 dump(比在源机跑更安全)
ssh user@src "mysqldump --single-transaction --all-databases" > /data/backup/db/$(date +%F).sql
--single-transaction 让 InnoDB 在不锁表的情况下拿到一致性快照,线上库也能安全导出。
FAQ
Q:和用云盘(对象存储)备份比,哪个好?
不冲突。rsync 快照适合"整目录、可回滚",对象存储适合"长期归档、异地容灾"。预算够就两条腿走:本地快照 + 定期推到对象存储。
Q:备份源和备份机都在同一家 VPS 商,算异地吗?
勉强算,但同机房/同区域的风险是共担的。真要抗灾,换一家服务商或跨区域。
Q:多久验证一次备份有效?
每月至少一次恢复演练,挑最旧和最新两端各测一次。便宜、快速、能救命。
Q:备份机上的快照怎么判断哪份是好的?
看日期目录名 + 体积。体积突然从 2 GB 掉到 50 MB,多半是源目录出问题了——要么被误删,要么挂载掉了。给巡检脚本加一条"本次快照体积低于上次的 50% 就告警",能提前抓到这类异常。
Q:能不能只备份改动的文件,别整目录扫?
rsync 本来就是增量传输(只传差异块),但"扫描"仍会遍历整个目录树。文件量特别大时,可以用 --delete + --link-dest 的快照法,扫描开销远低于全量拷贝,日常无感。
发布前自查
- [ ] 免密登录已通,key 权限 600
- [ ] 首次运行成功,
2026-xx-xx/目录已生成 - [ ] 第二次运行后
du -sh显示占用没有翻倍(说明--link-dest生效) - [ ] cron 已挂、日志有输出、心跳监控已接
- [ ] 恢复演练至少做过一次
小结
整套配置二十分钟,之后就是全自动。它挡住的是三类灾难:误删文件、磁盘损坏、勒索加密。成本是每天几秒 CPU,收益是你睡得着觉。 补上一条心跳监控,连"它今天到底跑没跑"这个焦虑都省了。
常见问题
--link-dest 是怎么省空间的?
未变化的文件在上一次快照里做硬链接,不复制实体;只有改动过的文件才真正占新空间,所以能保留很多天历史却接近一份的体积。
怎么确认备份任务真的在跑?
看日志。cron 里把输出重定向到 /var/log/backup.log;更稳妥的做法是给任务加一个"心跳上报",超过 24 小时没上报就报警。