
静态博客也能有自己的评论区和访问计数:用 Cloudflare Workers 做接口、D1 做存储,前端一个 fetch 就能调,整套跑在免费额度内,不需要任何一台服务器。 D1 是 Cloudflare 基于 SQLite 的 Serverless 数据库,免费档每天 500 万行读取、10 万行写入、5GB 存储——个人博客的留言和 PV 计数,连零头都用不完。我 2026 年 10 月把博客上挂了三年的第三方评论脚本换成了这套自建方案,页面加载快了一截,数据也终于躺在自己手里。
这篇按真实操作顺序走完整个链路:wrangler 建库建表、Worker 里写接口、绑定域名部署、前端调用,最后用 Turnstile 把垃圾评论挡在写入之前。所有命令在 Ubuntu 22.04 和 wrangler 4.x 下验证过。
为什么要换成 D1,而不是接着用第三方评论?
结论:第三方评论系统的问题是数据不在自己手里、加载慢、还随时可能关停,而 D1 把存储挪到了 Cloudflare 边缘,和 Workers 同一个请求里就能读写。 之前用的那个评论服务,脚本要从两个额外域名拉东西,Lighthouse 上拖了分;最难受的是想导出数据时才发现,导出格式是私有的。换成自建之后,数据就是两张 SQLite 表,随时 wrangler d1 export 拿走。
| 维度 | 第三方评论服务 | Workers + D1 自建 |
|---|---|---|
| 数据归属 | 在服务商手里,导出受限 | 自己的 SQLite 表,随时导出 |
| 额外请求 | 脚本 + 接口分属多个域名 | 同域或同源,延迟低 |
| 费用 | 免费档限制多,超了要钱 | 免费额度对博客基本无限 |
| 反垃圾 | 内置但不可控 | 自己接 Turnstile,规则自己定 |
| 维护成本 | 零 | 半天搭好,之后基本不用管 |
要不要自己接 Turnstile 这事我犹豫过,后来看了之前那篇留言板被刷两千条的教训,直接一步到位。人机验证的完整配置在这篇里不展开,只放关键接入点,细节可以看Turnstile 那篇。
整体链路长什么样?
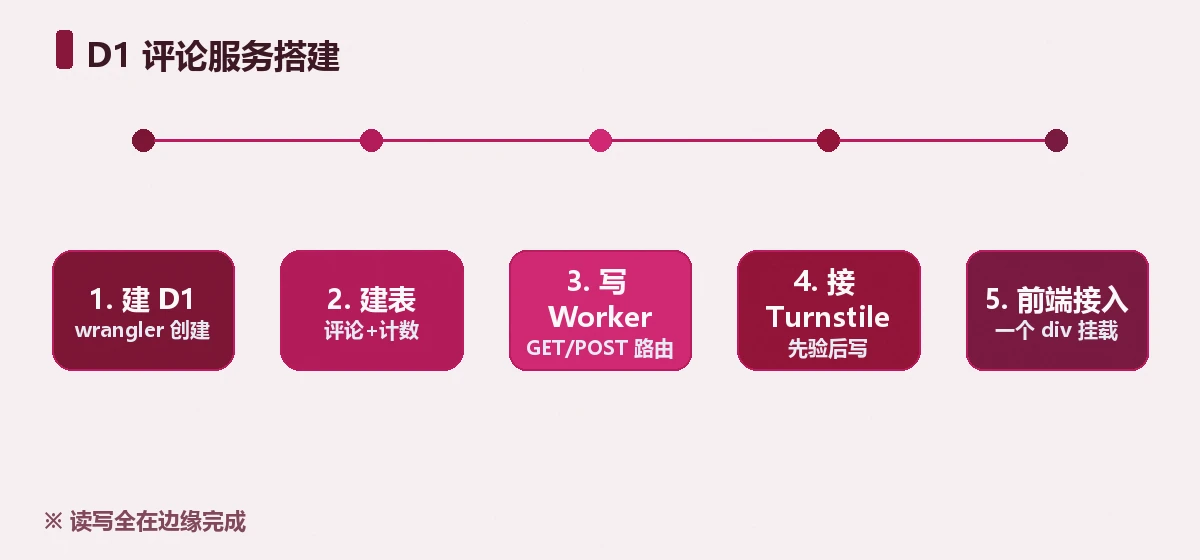
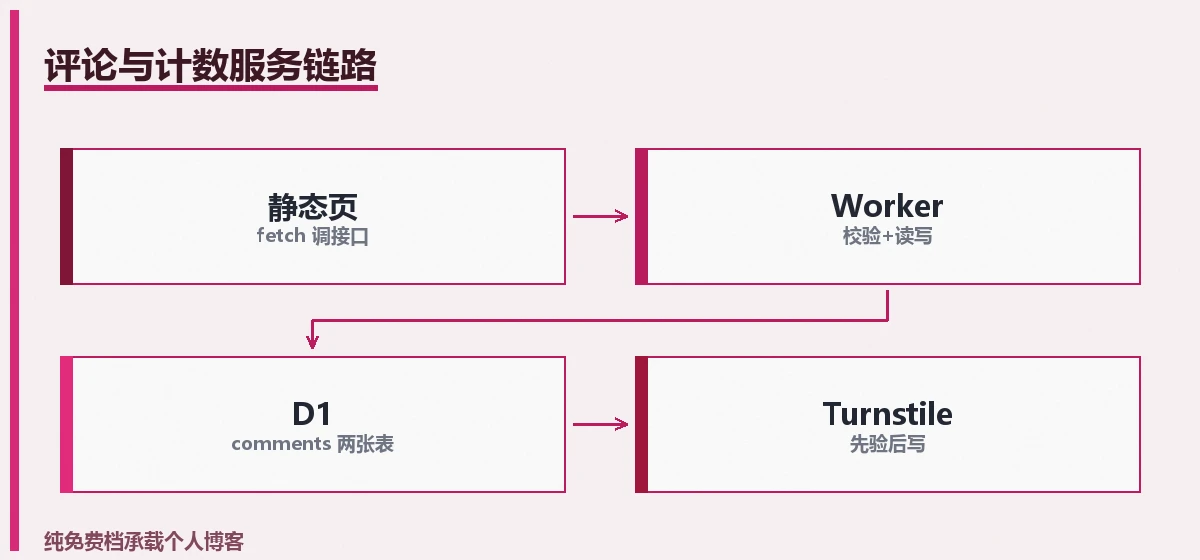
链路一共四步:建库建表、写 Worker、绑域名部署、前端接上。前端只发两种请求:POST /view 上报一次浏览并拿回计数,GET /comments 拉评论列表,POST /comments 提交新评论。Worker 是唯一的后端,D1 是唯一的存储,没有其他依赖。
第一步:用 wrangler 建库建表
$ npm install -g wrangler
$ wrangler --version
4.40.0
$ wrangler login
$ wrangler d1 create blog-comments
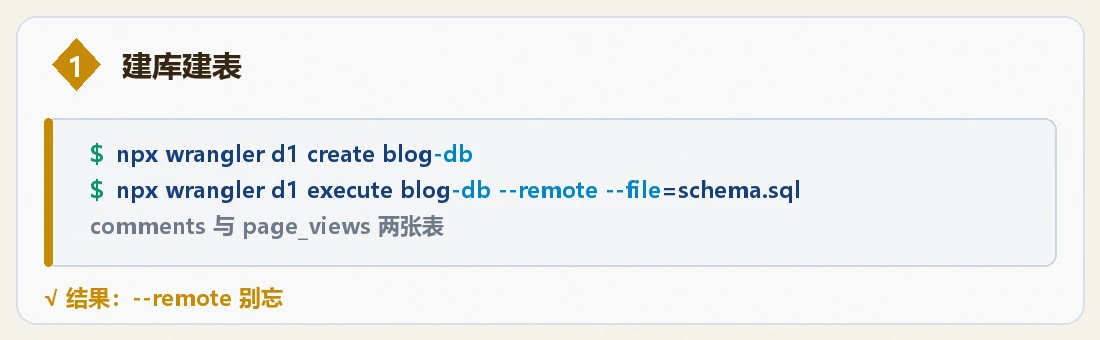
d1 create 的输出里会给出 database_id,把它记下来,待会写进 wrangler.toml。然后建两张表,schema.sql 内容:
CREATE TABLE IF NOT EXISTS comments (
  id INTEGER PRIMARY KEY AUTOINCREMENT,
  page TEXT NOT NULL,
  nickname TEXT NOT NULL,
  content TEXT NOT NULL,
  created_at TEXT DEFAULT (datetime('now'))
);

CREATE TABLE IF NOT EXISTS page_views (
  page TEXT PRIMARY KEY,
  views INTEGER DEFAULT 0
);
page 字段存文章的 slug 或者路径,评论区按页隔离全靠它。执行建表:
$ wrangler d1 execute blog-comments --file=./schema.sql --remote
第二步:Worker 里写 INSERT 和 SELECT
项目结构用最简形态:一个 wrangler.toml 加一个 src/index.js。
name = "blog-comments"
main = "src/index.js"
compatibility_date = "2026-01-01"

[[d1_databases]]
binding = "DB"
database_name = "blog-comments"
database_id = "你的 database_id"

routes = [
  { pattern = "api.example.com", custom_domain = true }
]
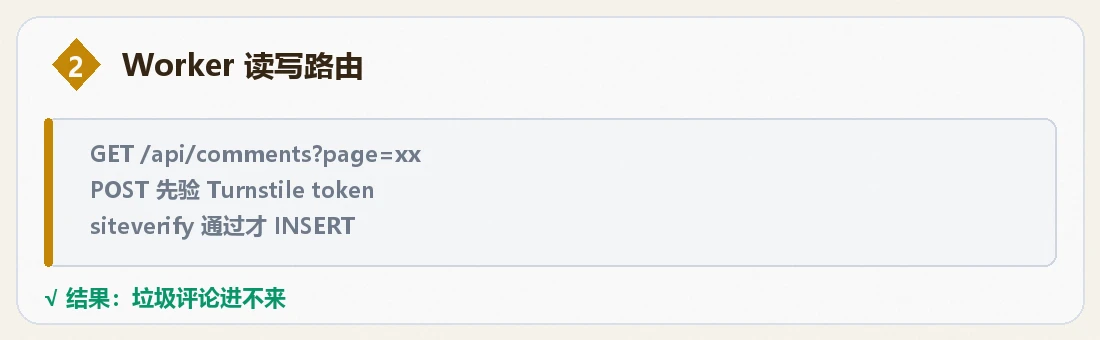
Worker 代码里,计数用一句 upsert 完成「写入加一、顺手读回」:
export default {
  async fetch(request, env) {
    const cors = {
      "Access-Control-Allow-Origin": "https://blog.example.com",
      "Access-Control-Allow-Headers": "Content-Type",
    };
    const url = new URL(request.url);

    if (url.pathname === "/view" && request.method === "POST") {
      const { page } = await request.json();
      await env.DB.prepare(
        "INSERT INTO page_views (page, views) VALUES (?1, 1) " +
        "ON CONFLICT(page) DO UPDATE SET views = views + 1"
      ).bind(page).run();
      const row = await env.DB.prepare(
        "SELECT views FROM page_views WHERE page = ?1"
      ).bind(page).first();
      return Response.json({ views: row.views }, { headers: cors });
    }

    if (url.pathname === "/comments" && request.method === "GET") {
      const page = url.searchParams.get("page");
      const rows = await env.DB.prepare(
        "SELECT nickname, content, created_at FROM comments " +
        "WHERE page = ?1 ORDER BY id DESC LIMIT 100"
      ).bind(page).all();
      return Response.json(rows.results, { headers: cors });
    }

    if (url.pathname === "/comments" && request.method === "POST") {
      const { page, nickname, content, token } = await request.json();
      const check = await fetch(
        "https://challenges.cloudflare.com/turnstile/v0/siteverify", {
          method: "POST",
          body: new URLSearchParams({
            secret: env.TURNSTILE_SECRET,
            response: token,
          }),
        }
      ).then(r => r.json());
      if (!check.success) {
        return Response.json({ error: "人机验证未通过" }, { status: 403, headers: cors });
      }
      await env.DB.prepare(
        "INSERT INTO comments (page, nickname, content) VALUES (?1, ?2, ?3)"
      ).bind(page, nickname.slice(0, 30), content.slice(0, 500)).run();
      return Response.json({ ok: true }, { headers: cors });
    }

    return new Response("Not Found", { status: 404 });
  }
};
参数全部用 ?1 ?2 占位符绑定,不要拼接字符串,这是防注入的底线。昵称和内容在写入前截断,防止有人灌一篇长文进库。
第三步:绑定路由并部署
$ wrangler secret put TURNSTILE_SECRET
$ wrangler deploy
$ curl -X POST https://api.example.com/view \
    -H "Content-Type: application/json" \
    -d '{"page":"/posts/hello-world/"}'
{"views":1}
custom_domain = true 的写法会直接把 api.example.com 注册成 Worker 的专属域名,DNS 记录 Cloudflare 自己接管,不用手动去加 CNAME。Turnstile 的 secret 一定要用 wrangler secret put 存成加密变量,别写在 [vars] 里——vars 在仪表盘上是明文可见的。
第四步:前端 fetch 调用
评论框加 Turnstile 小组件,提交时把 token 一起带上来:
<script src="https://challenges.cloudflare.com/turnstile/v0/api.js" async></script>
<div class="cf-turnstile" data-sitekey="你的 sitekey"></div>

<script>
const API = "https://api.example.com";

async function reportView(page) {
  const res = await fetch(API + "/view", {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ page }),
  });
  const { views } = await res.json();
  document.getElementById("pv").textContent = views;
}

async function submitComment(page, nickname, content, token) {
  const res = await fetch(API + "/comments", {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ page, nickname, content, token }),
  });
  return res.ok;
}
</script>
每篇文章在页脚放一个 <span id="pv"></span>,reportView(location.pathname) 一调,计数就亮了。评论列表用 GET 拉回来自己渲染,样式完全自己控制,不再受第三方组件的气。
部署完怎么验证、平时怎么看它活着?
上线之后别只看首页计数在跳,要按链路把三个环节各验一遍。 第一验接口本身:curl 直接打 /view 和 /comments,返回 JSON 就说明 Worker、绑定、D1 三件事都通了;第二验跨域:用浏览器开发者工具看前端请求有没有被 CORS 拦下,如果博客域名和 Access-Control-Allow-Origin 写得不一致,控制台会有红字,这是最常见的假故障;第三验写入:wrangler d1 execute blog-comments --remote --command "SELECT * FROM comments ORDER BY id DESC LIMIT 3" 直接看最近三条,比在前端盯刷新直观得多。
平时想看运行状态,两个入口够用。一个是 wrangler tail,实时吐出 Worker 的请求日志,报错栈都在里面,我排查 403 时全靠它;另一个是仪表盘的用量页,Workers 请求数、D1 读取写入行数都有曲线,免费档的额度消耗一目了然。垃圾评论的拦截效果也能在这里侧面观察:开了 Turnstile 之后,评论表的新增频率肉眼可见地回落,剩下的都是真实读者。我的评论表现在一周新增十几条,计数表攒了两千多行,体验上和托管服务没有任何差别,但每一行数据都是自己的。
我踩的最大一个坑
我一开始以为 wrangler d1 execute 不加参数就是打线上库,后来发现它默认执行在本地副本上。 那天我在本地建了表、插了测试数据、接口全调通了,部署上去之后前端一拉,列表永远是空的。排查了半天 CORS 和绑定,最后才想明白:我忘了加 --remote,线上库里连表都不存在。D1 的本地开发模型是「命令默认写本地 SQLite 文件,加 --remote 才碰线上」,这个设计对开发友好,但对新手是真的阴。现在我的习惯是:凡是想在线上生效的操作,命令末尾必带 --remote,执行完再 wrangler d1 execute blog-comments --remote --command "SELECT count(*) FROM comments" 确认一遍。
还有一个小的:Turnstile 校验那步,env.TURNSTILE_SECRET 在本地 wrangler dev 里是读 .dev.vars 文件的,线上才是 secret。两套环境变量名保持一致,否则本地好好的,部署上去全 403。
常见问题
Q:免费额度真的够用吗?
A:D1 免费档是每天 500 万行读取、10 万行写入、5GB 存储。一篇访问量几百的文章每天读写几十行,个人博客离额度上限差着几个数量级,放心用。
Q:数据怎么备份?
A:wrangler d1 export blog-comments --remote --output=dump.sql 一条命令导出完整 SQL,可以放进 CI 里定期跑,再把文件推到对象存储。表结构就两张,恢复也简单。
Q:旧评论能迁过来吗?
A:能。从旧系统导出成 JSON 或 CSV,写个十几行的脚本转成 INSERT 语句存成 .sql 文件,wrangler d1 execute blog-comments --remote --file=import.sql 一次灌入。时间戳字段记得一并带上,评论顺序才不会乱。
上线后加的第一个功能是通知:POST 路由在写入成功后,顺手把评论内容发到飞书 Webhook,一眼知道有没有人来留言。第二个是审核开关:环境变量里放一个 MODERATION 标记,开启时评论先写 pending 状态、后台确认后才可见——个人博客的评论区,宁可慢半拍也不能挂垃圾。这两个功能各花了一小时,但让这个免费服务真正能长期开着不用管。